Encoder-Free 多模态预训练:去掉视觉编码器之后
交互教程
像素直接进入语言解码器后,视觉计算去了哪里?额外训练成本又可能在何种规模消失?
前置阅读:ViT · CLIP 与 SigLIP 系列 · 多模态模型中的视觉 tokenizer 总览
之前已经能做什么
Section titled “之前已经能做什么”去掉编码器,究竟去掉了什么?
Section titled “去掉编码器,究竟去掉了什么?”阅读对象:Lin Chen 等,How Far Are We from Removing the Visual Encoder? Scaling Laws for Encoder-Free Multimodal Pretraining,arXiv:2609.35457v1,2026 年 9 月 28 日。讲解覆盖正文与附录 A–G。
视觉编码器在语言解码器读取图像之前,把 patches 转为带上下文的表示。预训练权重提供视觉先验。Encoder-free 仍保留输入投影,只是把表征学习移入解码器,并没有消除视觉计算。
本文问的是,这种改变如何影响算力分配:新增预算应投入更大的解码器,还是更多训练 token?证据来自受控预训练扫描,而非不同旗舰模型的横向排名。
结论要分成两部分:实测范围内,无编码器的多模态前沿更差;拟合的改善速度更快,因此可以有条件地预测未来追平。第二句话不是已经观察到交点。
- 论文:§1 — 2609.35457v1
相同解码器阶梯,固定规模的视觉编码器
Section titled “相同解码器阶梯,固定规模的视觉编码器”两组都使用 11 档稀疏 MoE 解码器:非 embedding 总参数 1.1B–44B,激活参数 71M–2.4B。首层是 dense,后续层有 256 个路由专家、top-8 激活及一个共享专家,使用 RMSNorm 与 RoPE。总参数与激活参数反映不同成本。
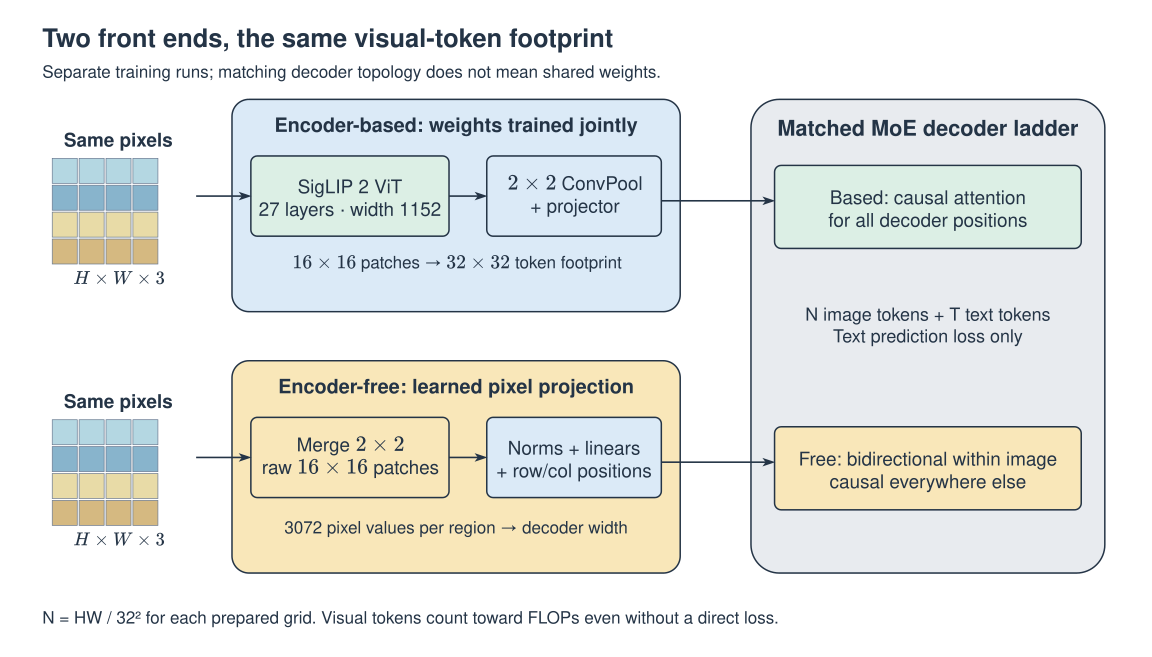
输入像素、预处理、数据混合与解码器视觉 token 数相同,每个视觉 token 对应 32×32 像素区域。预训练 SigLIP 2 编码器约 400M 参数:27 层、宽度 1152、patch 16、AnyRes。权重与解码器联合训练;固定的是各档实验中的编码器架构规模。
因此,研究隔离的是固定规模视觉先验下的解码器扩展,没有联合优化编码器与解码器规模。两组主方案的 mask 也不同;无编码器因果消融用于检查分配规律是否依然成立。
- 论文:Appendix A.1–A.2 — 2609.35457v1
改变了什么,为什么
Section titled “改变了什么,为什么”点击图中蓝色边框内的模块,查看形状、公式和伪代码。也可用 Tab 选中模块,再按 Enter。
1. 预训练视觉前端
形状 / 接口:N16 × 1152 → N × d
对高 H、宽 W 且可被 32 整除的预处理图像网格,ViT 首先生成 HW/256 个宽度 1152 的 patch 特征。2×2 ConvPool 把空间 token 数降为四分之一,projector 映射到解码器宽度 d。解码器中所有 token 使用因果注意力;图像内部的双向交互已由 ViT 完成。
features = siglip2(image)             # N16 × 1152
visual = projector(conv_pool_2x2(features))  # N × d
logits = decoder(interleave(text, visual), causal_mask)
loss = cross_entropy(logits[text_targets], targets)训练状态:联合预训练;按论文编写的教学伪代码,未审计官方代码。
2. 原始像素前端
形状 / 接口:N × 3072 → N × h → N × d
无编码器分支把四个相邻 16×16 原始 patches 合成一个 32×32 区域,每个区域含 3072 个像素标量。LayerNorm → linear → LayerNorm 变换该向量,再加上可学习的行、列位置 embedding,最后通过 LayerNorm → RMSNorm → linear 映射到解码器宽度。论文没有给出每个中间宽度,所以下式保留符号 h。
pixels = merge_2x2(raw_patches_16(image))
u = ln2(linear1(ln1(pixels)))
u = u + row_position + column_position
visual = linear2(rmsnorm(ln3(u)))
logits = decoder(interleave(text, visual), image_bidirectional_mask)训练状态:联合预训练;按论文编写的教学伪代码,未审计官方代码。
3. 解码器注意力
形状 / 接口:(N + T) × d → text logits
Query 可以读取更早的 key;在无编码器主方案中,若两者属于同一图像,还允许读取更晚的视觉 key。这不会暴露未来文本。生成文本时,已给定图像 token 是上下文;这个 mask 不是像素生成规则。交互示例使用两个文本 token、四个图像 token 和两个后续文本 token。
allow = causal | same_image
loss = CE(logits[text_targets], targets)训练状态:联合预训练;按论文编写的教学伪代码,未审计官方代码。
从预训练视觉特征到解码器 token
Section titled “从预训练视觉特征到解码器 token”对高 H、宽 W 且可被 32 整除的预处理图像网格,ViT 首先生成 HW/256 个宽度 1152 的 patch 特征。2×2 ConvPool 把空间 token 数降为四分之一,projector 映射到解码器宽度 d。解码器中所有 token 使用因果注意力;图像内部的双向交互已由 ViT 完成。
features = siglip2(image)             # N16 × 1152
visual = projector(conv_pool_2x2(features))  # N × d
logits = decoder(interleave(text, visual), causal_mask)
loss = cross_entropy(logits[text_targets], targets)- 论文:Appendix A.1 — 2609.35457v1
原始像素仍需可训练的输入前端
Section titled “原始像素仍需可训练的输入前端”无编码器分支把四个相邻 16×16 原始 patches 合成一个 32×32 区域,每个区域含 3072 个像素标量。LayerNorm → linear → LayerNorm 变换该向量,再加上可学习的行、列位置 embedding,最后通过 LayerNorm → RMSNorm → linear 映射到解码器宽度。论文没有给出每个中间宽度,所以下式保留符号 h。
该方案借鉴 Gemma 4 12B Unified 的输入配方,但为对照实验把 3×3 patch 合并改成 2×2。直接照搬原版 48×48 token 覆盖范围会破坏相同 token 数的条件。多个 AnyRes 网格应分别按预处理后的形状计算。
pixels = merge_2x2(raw_patches_16(image))
u = ln2(linear1(ln1(pixels)))
u = u + row_position + column_position
visual = linear2(rmsnorm(ln3(u)))
logits = decoder(interleave(text, visual), image_bidirectional_mask)- 论文:Appendix A.1 — 2609.35457v1
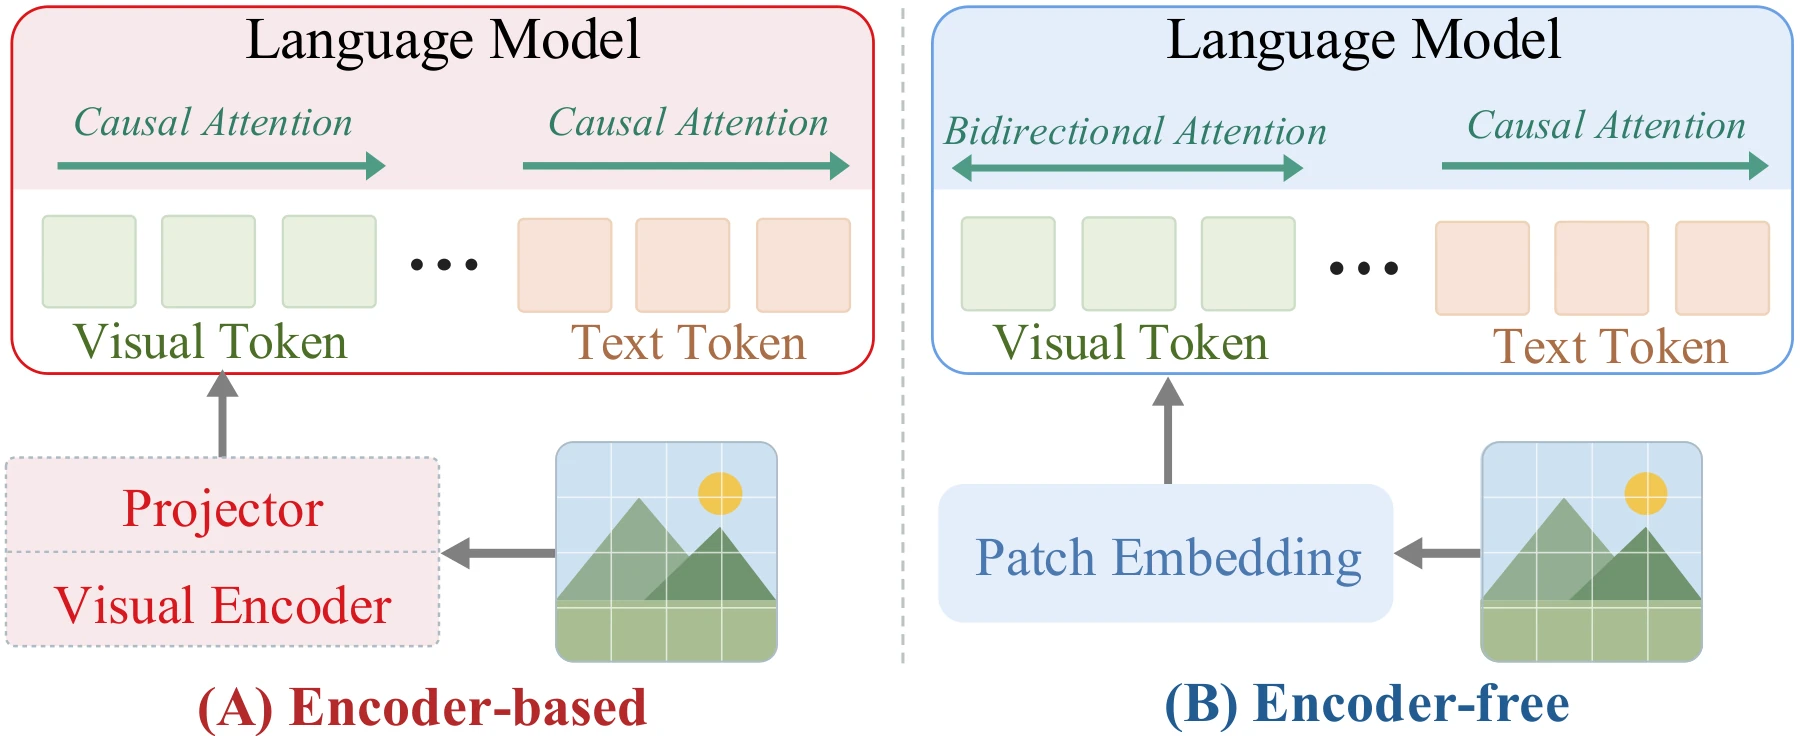
同一图像内部双向,其余位置因果
Section titled “同一图像内部双向,其余位置因果”Query 可以读取更早的 key;在无编码器主方案中,若两者属于同一图像,还允许读取更晚的视觉 key。这不会暴露未来文本。生成文本时,已给定图像 token 是上下文;这个 mask 不是像素生成规则。交互示例使用两个文本 token、四个图像 token 和两个后续文本 token。
- 论文:§2.3, §3.3 — 2609.35457v1
逐步理解机制
Section titled “逐步理解机制”计算处理量,而不仅是有监督的位置
Section titled “计算处理量,而不仅是有监督的位置”C 是对应目标的训练 FLOPs,M 是每个已处理 token 的解码器 FLOPs,D 是处理的 token 数。视觉位置不参与交叉熵,却计入多模态 D。注意力成本还取决于打包长度和 mask,因此相同 token 数不意味着 M 完全相同。M 也不是 MoE 总参数量。
主图统计解码器计算量。附录 C 加计当前视觉前端训练成本后,分配规律的定性次序保持不变;这种补计没有包含历史 SigLIP 2 预训练成本。两种口径都不是完整生命周期成本或实测硬件延迟。
- o
- 文本或多模态目标
- s
- 无编码器或有编码器模型族
- ℓ
- 对应目标的平均打包序列长度
- 论文:§2.4; Appendix C — 2609.35457v1
IsoFLOP:同一预算应该怎样花?
Section titled “IsoFLOP:同一预算应该怎样花?”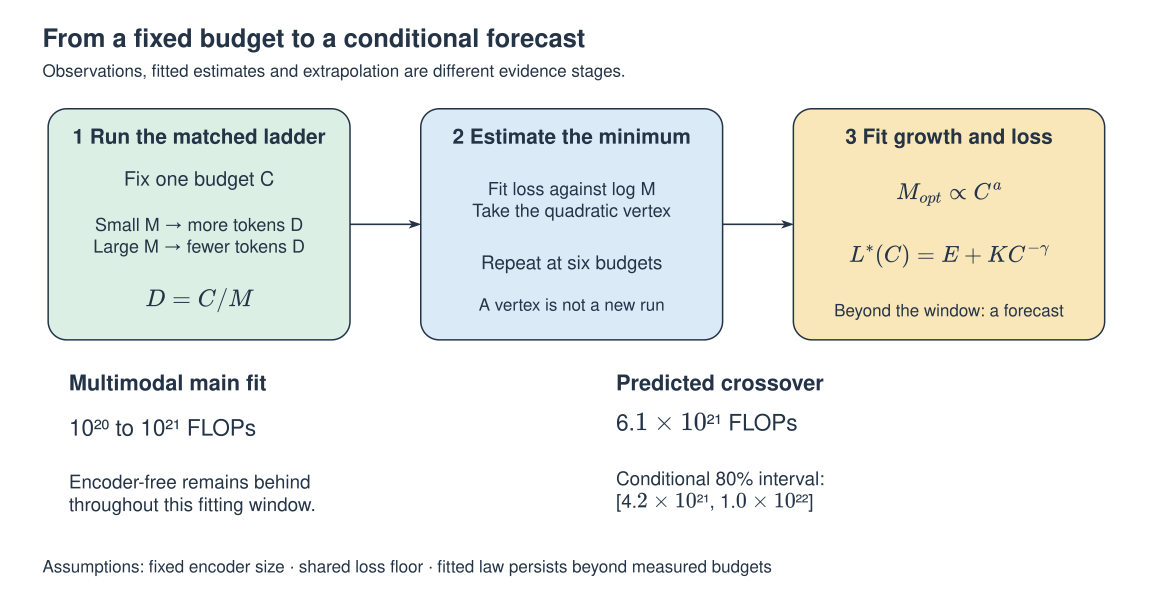
固定 C,选择不同解码器规模 M,为每个规模分配 D=C/M 个 token。模型过小可能受容量限制,模型过大则训练 token 太少。将验证 loss 对 log M 拟合为二次曲线并取最小值;跨预算重复后得到分配规律与 loss 前沿。拟合最小值是估计,不是额外的一次训练。
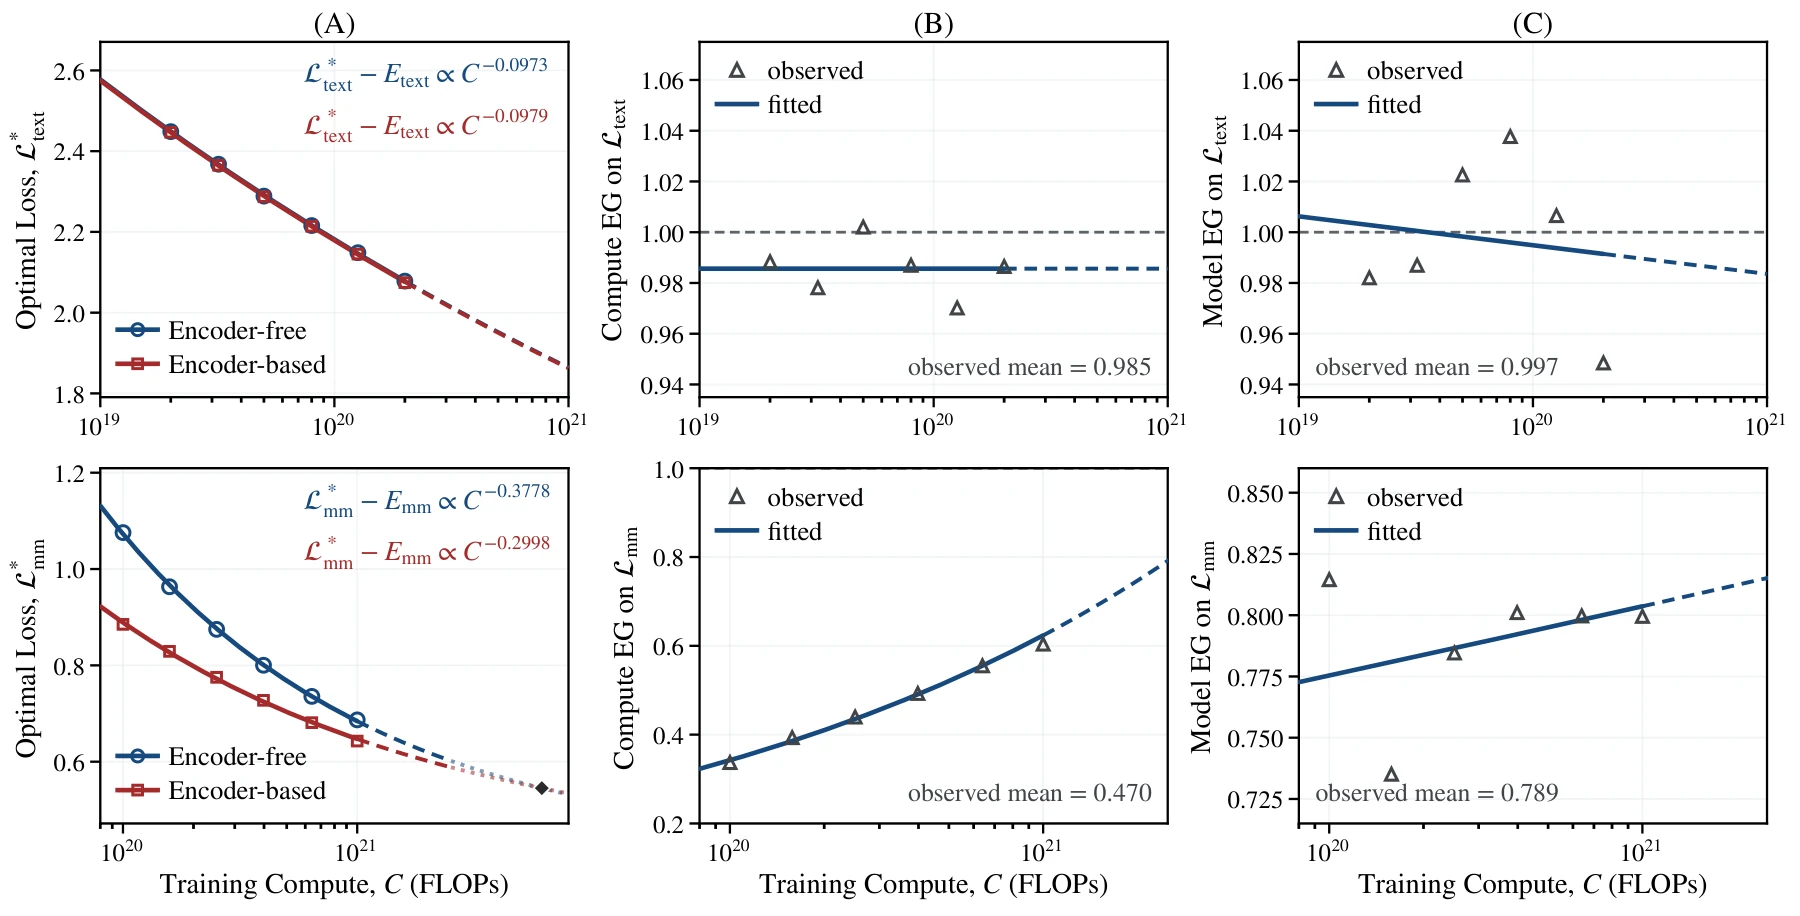
每个目标使用六个对数间隔预算:文本窗口为 2×10¹⁹–2×10²⁰ FLOPs,多模态为 10²⁰–10²¹。指数描述各模型族内部的增长。归一化交互把各自最小预算时的值设为 1,因此两条线不能比较模型的绝对规模。
| 目标/模型族 | a | b | γ |
|---|---|---|---|
| Text / Free | 0.427 | 0.573 | 0.0973 |
| Text / Based | 0.422 | 0.578 | 0.0979 |
| Multimodal / Free | 0.570 | 0.430 | 0.3778 |
| Multimodal / Based | 0.464 | 0.536 | 0.2998 |
- 论文:Appendix A.5 — 2609.35457v1
- 论文:Table 2: IsoFLOP estimates — 2609.35457v1
先推导最优点,再解释指数
Section titled “先推导最优点,再解释指数”对可分离近似 L=E+AM⁻ᵅ+BD⁻ᵝ,代入 D=C/M 后对 M 求导。驻点平衡的是两项的边际 loss 贡献,并非要求原始数值相等。求解得到 a=β/(α+β)、b=α/(α+β)、γ=αβ/(α+β)。论文从 IsoFLOP 剖面估计分配指数;这个推导用于理解过度训练分析背后的模型。
更大的多模态 a 表示预算增长时更多增量用于扩展解码器,并非“总 FLOPs 的 57% 用来购买参数”。预算扩大十倍时,a=0.570 对应基准 M 的约 3.72 倍和 D 的约 2.69 倍。
- 论文:Appendix D — 2609.35457v1
相同 loss,两种不同的效率比
Section titled “相同 loss,两种不同的效率比”以无编码器为 target,有编码器为 reference。EGᶜ 比较达到相同 loss 所需的计算量;EGᴹ 比较该 loss 下选用的每 token FLOPs。小于 1 对无编码器不利。例如 EGᴹ=0.80 表示每 token FLOPs 是 1/0.80=1.25 倍,而非参数减少 20%。
- 论文:§2.2; §3.2 — 2609.35457v1
探索预算分配规律
各模型族以自身基准归一化。曲线是解析规律,不是训练观测。实线覆盖论文拟合窗口,虚线延伸该规律。圆点表示你选择的预算,不代表实测运行。
1.00× 预算 · 1.00e+20 decoder FLOPs · 拟合窗口内
● 无编码器● 有编码器
| 模型族 | a | M / M₀ | D / D₀ |
|---|---|---|---|
| 无编码器 | 0.570 | 1.0000 | 1.0000 |
| 有编码器 | 0.464 | 1.0000 | 1.0000 |
在 10 倍边界,多模态无编码器分支的 M 增至 3.7154 倍,D 增至 2.6915 倍,乘积为 10。分别归一化不意味着起始容量相同或 loss 相同。来源:表 2,仅 decoder 算力口径。
逐格检查注意力掩码
T 表示文本,I 表示同一图像的四个位置。行是 query,列是 key。圆点表示允许读取。这里演示结构规则,不是实测注意力权重。
| Q / K | T0 | T1 | I0 | I1 | I2 | I3 | T2 | T3 |
|---|---|---|---|---|---|---|---|---|
| T0 | ● | – | – | – | – | – | – | – |
| T1 | ● | ● | – | – | – | – | – | – |
| I0 | ● | ● | ● | ● | ● | ● | – | – |
| I1 | ● | ● | ● | ● | ● | ● | – | – |
| I2 | ● | ● | ● | ● | ● | ● | – | – |
| I3 | ● | ● | ● | ● | ● | ● | – | – |
| T2 | ● | ● | ● | ● | ● | ● | ● | – |
| T3 | ● | ● | ● | ● | ● | ● | ● | ● |
I0 可读取:T0、T1、I0、I1、I2、I3。
第一个图像 query 新增三个后续图像 key,仍不能读取 T2、T3。两种模式下文本 query 都保持因果;后续文本可以读取前面的全部图像位置。此实验不运行模型,也不生成像素。
训练与实验证据
Section titled “训练与实验证据”交点在主拟合窗口之外
Section titled “交点在主拟合窗口之外”多模态主拟合截止于 10²¹ FLOPs,预测追平点为 6.1×10²¹ FLOPs。下表给出有条件的中央 80% bootstrap 区间,不保证新训练运行一定在区间内追平。它依赖规律持续成立、编码器规模固定及两组共享不可约 loss 下限。
按主题拟合预测 STEM 更早追平,其次是 Charts,GUI、OCR 与 Caption 更晚。这是验证主题上的预测,不能据此说所有图表 benchmark 已经由无编码器领先。
| 训练方式 | 预测交点 FLOPs | 条件 80% 区间 |
|---|---|---|
| k=1 | 6.1×10²¹ | [4.2×10²¹, 1.0×10²²] |
| k=5 | 1.2×10²² | [8.4×10²¹, 2.0×10²²] |
- 论文:§3.2 — 2609.35457v1
- 论文:Appendix B.4 — 2609.35457v1
固定模型规模,增加训练 token
Section titled “固定模型规模,增加训练 token”过度训练从 C_base 对应的最优模型开始,固定 M,将 token 数乘 k,实际计算量为 kC_base。代入可分离 loss 后,可约 loss 项乘上 g(k)。若横轴改为实际计算量,系数应写为 g(k)k^γ;漏掉这一步会误解效率。
理想化推导给出 g(k)=[β+αk⁻ᵝ]/(α+β)。论文实际固定 E、K、γ 后拟合经验系数;k=5 时,无编码器为 0.645,有编码器为 0.692。在最大拟合预算处,报告的多模态 EGᶜ 从 0.62 变为 0.52,EGᴹ 从 0.80 变为 0.74。更多 token 有助于降低 loss,但并未消除无编码器解码器扩容的相对收益。
- 论文:§3.2.2 — 2609.35457v1
- 论文:Appendix D; A.3 — 2609.35457v1
训练信号与解码协议
Section titled “训练信号与解码协议”预训练使用 1:1 文本/多模态混合、4096 序列长度、Muon 和 2000 步 warmup。Batch size 与学习率随解码器规模变化,按内部 scaling 规则选择;同档两方案超参数一致。目标是下一文本 token 预测,视觉 token 通过影响文本预测得到梯度。这些信息尚不足以构成完整公开复现配方。
下游评估不增加训练。所有 checkpoint 使用相同 3-shot 示例和提示,每个示例最多 192 个视觉 token,query 最多 768,整段 prompt 最多 4096 个 token。选择题与是非题按答案 likelihood 选取,开放题 greedy 解码最多 32 个 token,不使用外部 OCR。
- 论文:Appendix A.3–A.4 — 2609.35457v1
- 论文:Appendix G.2 — 2609.35457v1
Loss 陡降与视觉注意力变化
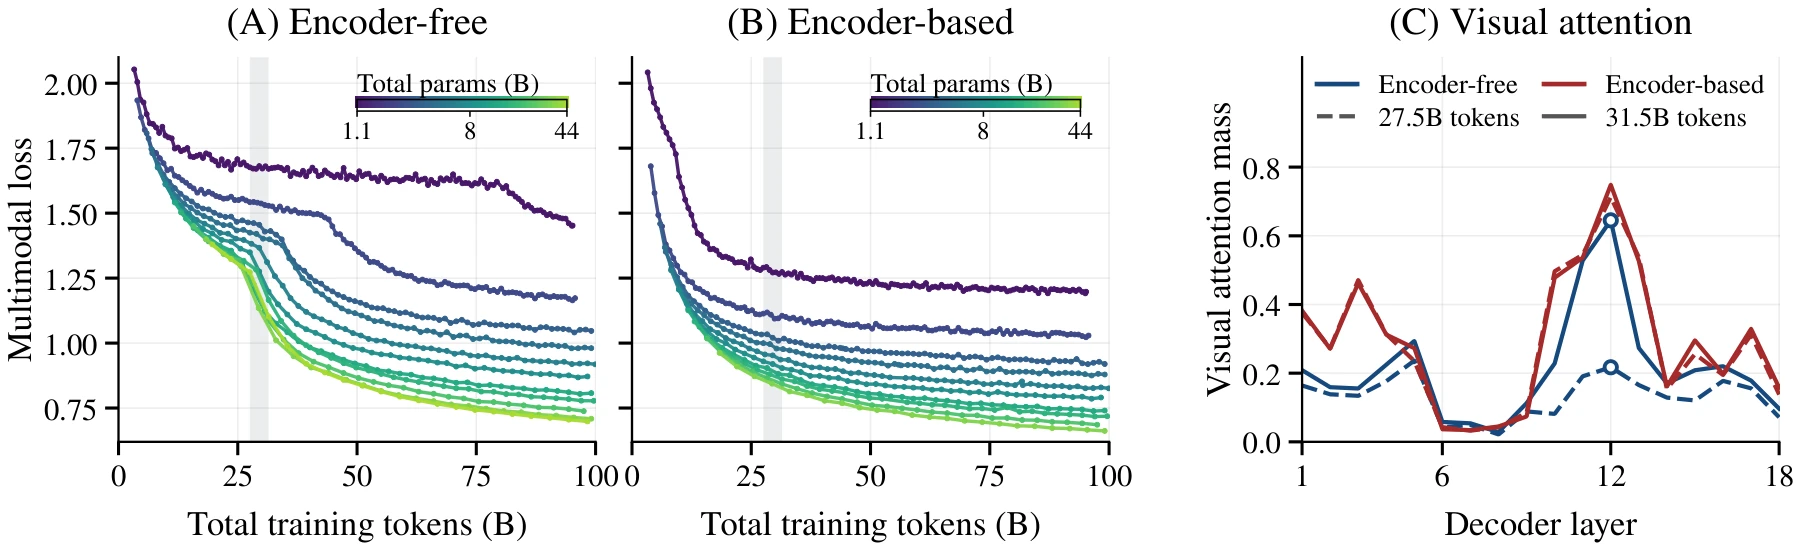
Section titled “Loss 陡降与视觉注意力变化”图 7 显示无编码器 loss 先下降缓慢,随后出现陡降。所分析 8B 模型在两个选定 checkpoint 间,第 12 层分配给视觉 token 的 attention mass 从 0.217 增至 0.645。作者假设存在反馈:弱视觉特征吸引的注意力少,特征变得有用后得到更多学习信号。这是对相关测量的解释,并非隔离变量后的因果干预。
- 论文:Figure 7; §3.3 — 2609.35457v1
定位计算变化,同时保留解释边界
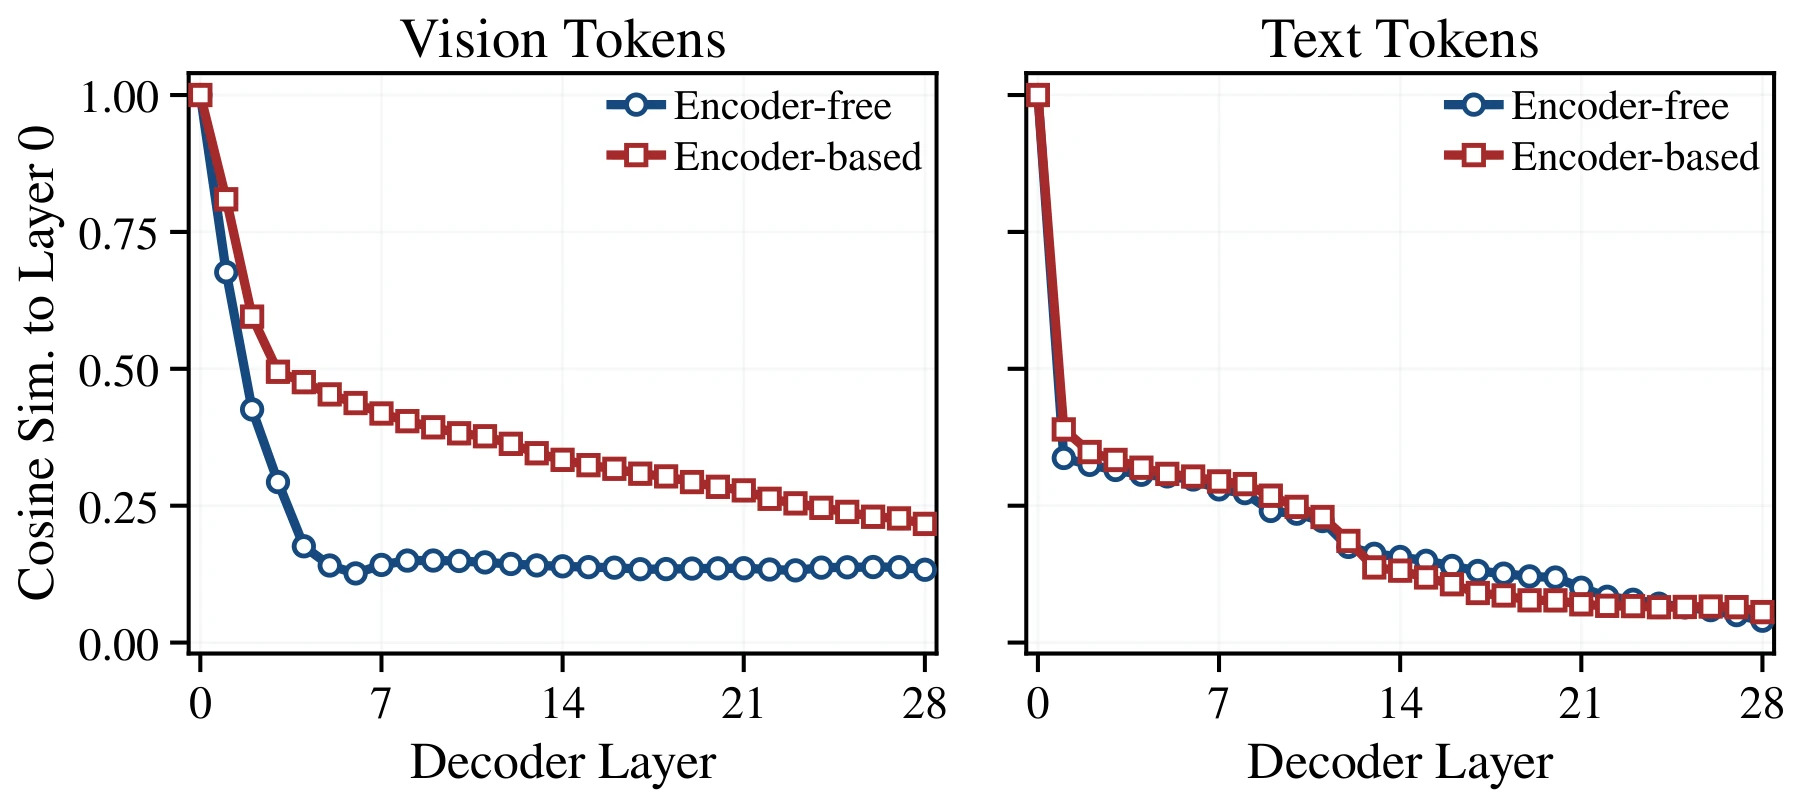
Section titled “定位计算变化,同时保留解释边界”无编码器解码器中的视觉 token 更早偏离输入表示,文本轨迹则较为接近。图 9 测量相对第 0 层的余弦相似度,不是语义准确率;附录 E 在多个深度重复观察。图 10 分模态检查专家负载后发现更强的视觉路由集中,整体统计可能掩盖这一点。更大 MaxVio 不等于已经识别了专家的语义。
因果 mask 消融的多模态模型分配指数仍为 0.557,双向方案为 0.570,因此分配变化不能仅用 mask 解释。论文中因果与双向的效率比以因果为 target,不能与上文无编码器/有编码器效率比混淆方向。
- 论文:Figures 9–10 — 2609.35457v1
- 论文:Appendix E.2 — 2609.35457v1
阅读图 10
Section titled “阅读图 10”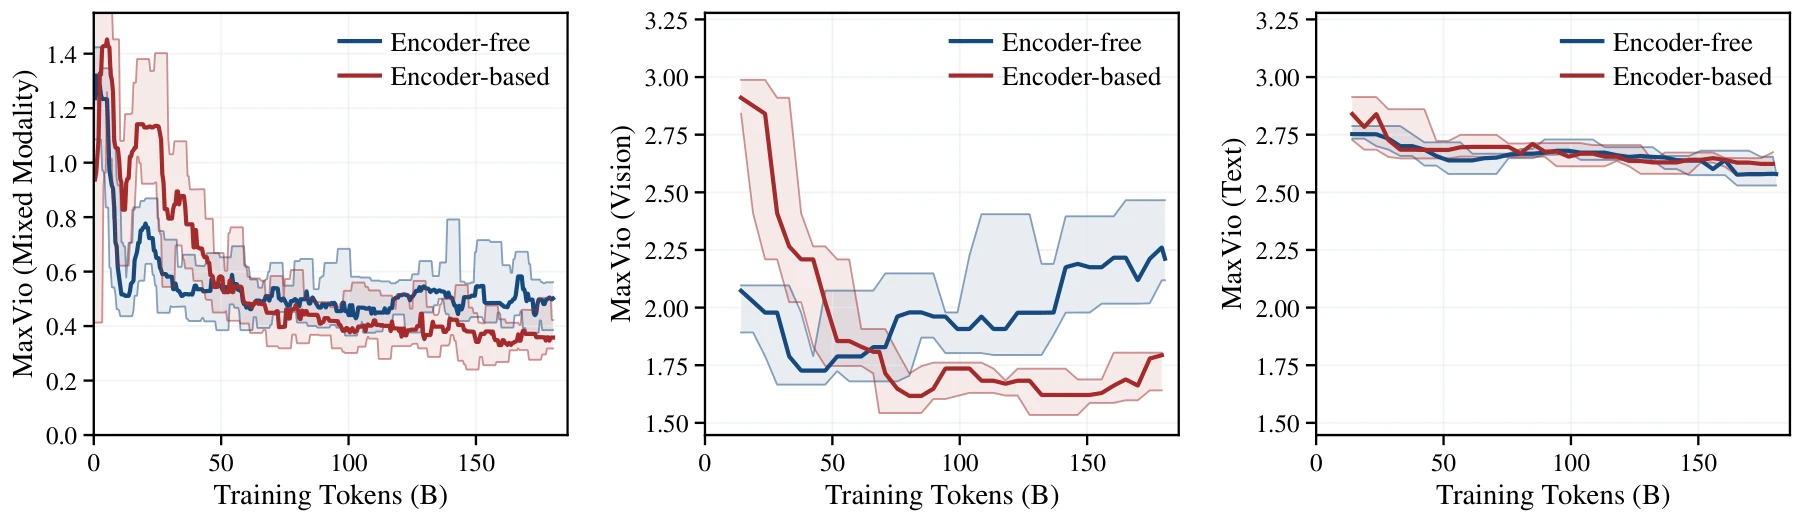
下游 benchmark 的平均差距仍在
Section titled “下游 benchmark 的平均差距仍在”约 100B 训练 token 时,表 6 在统一 3-shot 协议下报告下列 11 任务未加权平均值。平均混合了 accuracy、relaxed accuracy、ANLS 与 VQA consensus 等指标,并非一种统一准确率。总体差距缩小,但不保证每个规模或每项任务单调改善。
单项反例也应保留:6.1B-A425M 的 CV-Bench 上,无编码器为 46.9,有编码器为 42.5。论文关于无编码器仍落后的描述应读作总体趋势,不能扩展为每项 benchmark 都有相同次序。
| 总参数/激活参数 | Based | Free |
|---|---|---|
| 6.1B / 425M | 43.5 | 35.5 |
| 8B / 577M | 51.9 | 40.5 |
| 13B / 922M | 55.2 | 44.1 |
| 16B / 1B | 53.6 | 43.8 |
| 22B / 1.6B | 57.7 | 48.7 |
| 33B / 2.2B | 57.7 | 51.2 |
- 论文:Table 6; Appendix G — 2609.35457v1
阅读图 20
Section titled “阅读图 20”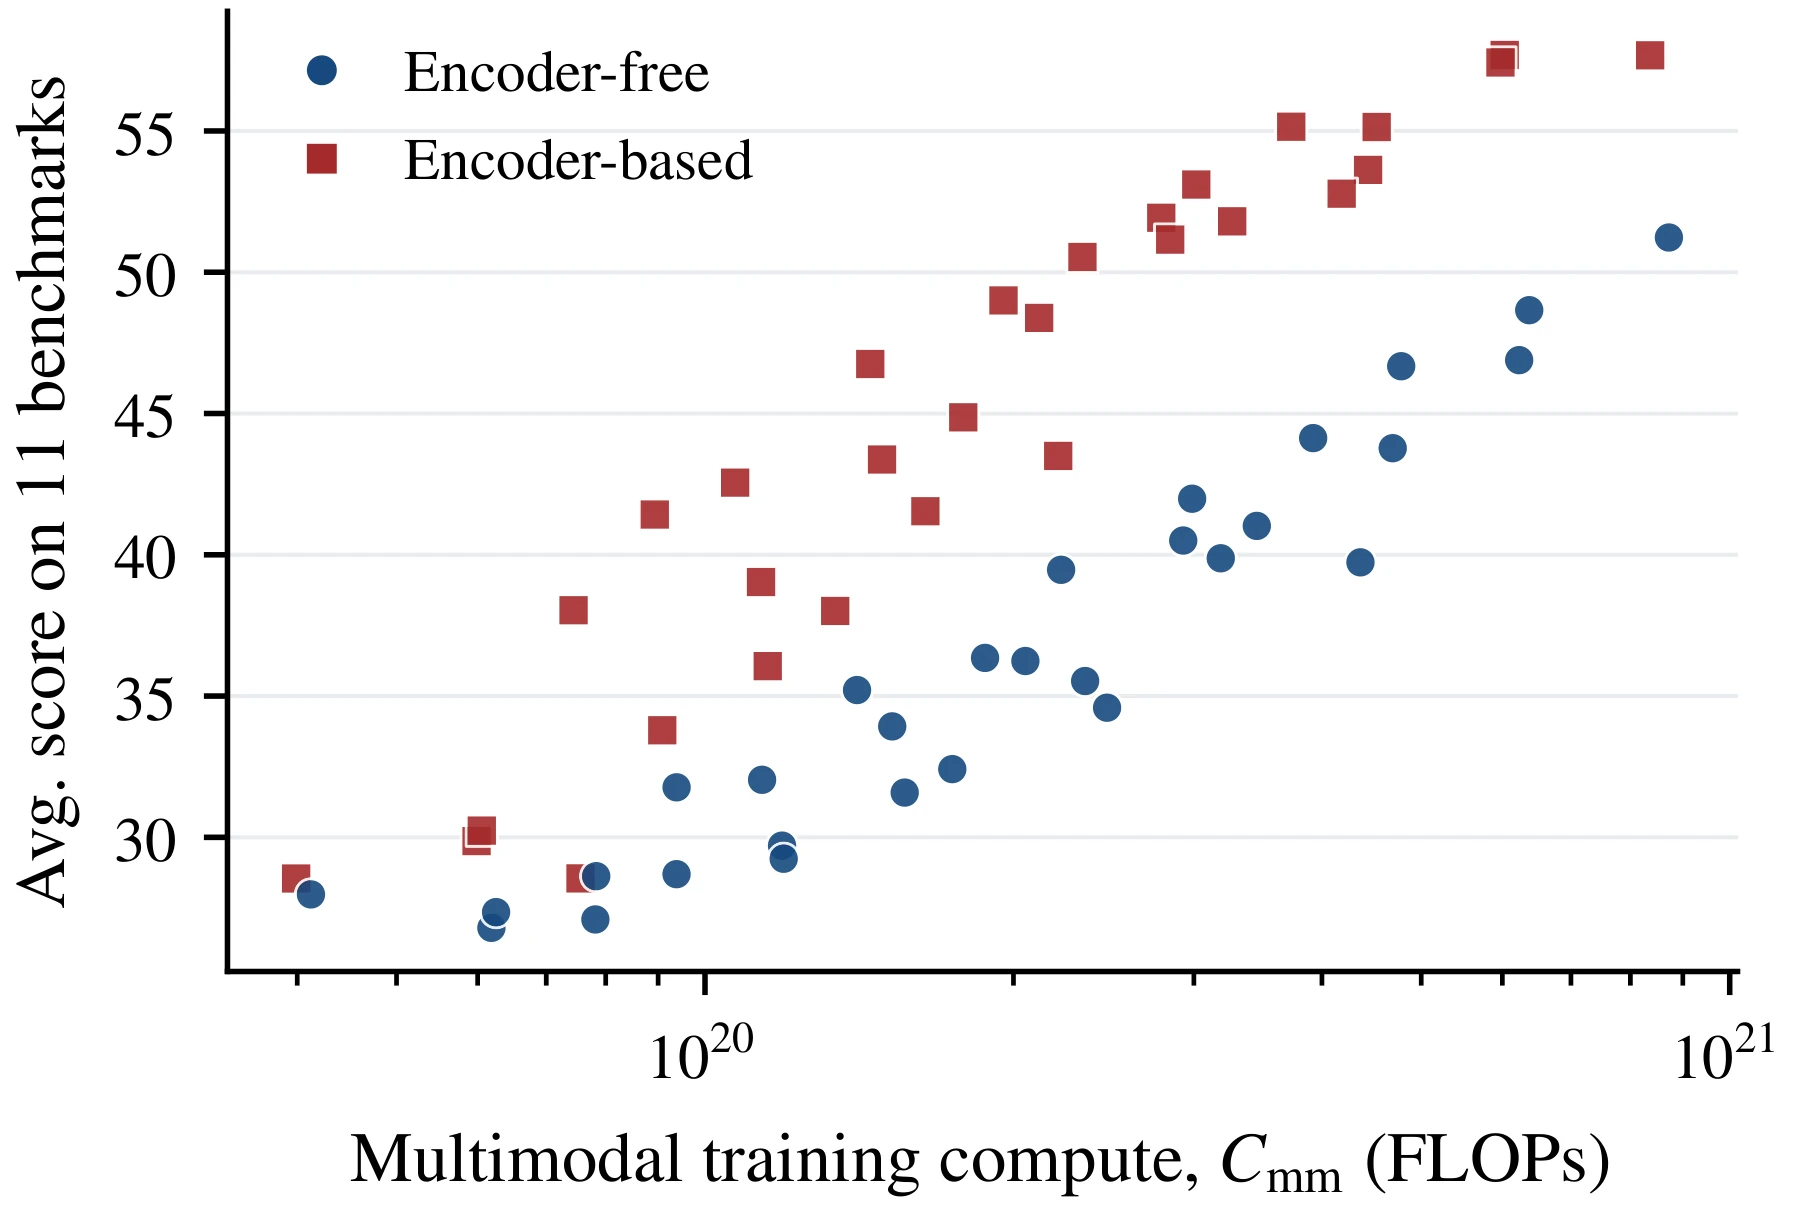
这些结果不能证明什么
Section titled “这些结果不能证明什么”哪些假设会改变预测?
Section titled “哪些假设会改变预测?”两组拟合在每个目标上共享下限 E。多模态拟合 E 为 0.403,但跨一个数量级的六个前沿点无法确定真正的渐近下限。将 E 扰动 ±10% 后,k=1 交点移至 [4.8,9.0]×10²¹ FLOPs;这是敏感性范围,不是置信区间。条件 bootstrap 使用 4000 次成对残差重采样;k=5 时保持已有过度训练系数固定。
多模态 2.5 倍预算留出预测的 loss 有符号误差为无编码器 −0.01%、有编码器 +2.19%。这项短距离检查有价值,但没有验证更远交点。固定编码器、MoE 拓扑、混合比例和预处理也限制结论迁移;联合扩大视觉编码器属于另一个分配问题。
按当前训练完整算力口径,附录 C 报告有编码器 a=0.273、γ=0.362,但没有重新拟合该口径下的精确交点。不能把这个指数与仅 decoder 口径的交点混合,称作实测总成本阈值。
- 论文:Appendix B.2–B.4 — 2609.35457v1
- 论文:Appendix C — 2609.35457v1
这如何改变对视觉输入模块的理解?
Section titled “这如何改变对视觉输入模块的理解?”这项结果将视觉 token 数与表征质量分开:相同数量不带来相同视觉先验。去掉编码器还可能把计算重新分配给解码器层和专家。因此值得联合研究架构与预算分配,但这不是让低预算项目直接删除现有视觉编码器的配方。
预测约 10²² FLOPs 追平,是否意味着无编码器已经胜出?
不是。多模态主拟合截止于 10²¹ FLOPs,追平是固定编码器规模、共享 loss 下限等条件下的外推。已评估范围内的下游平均分仍落后。
来源与后续阅读
Section titled “来源与后续阅读”自绘图和伪代码用于教学;原论文图片单独标注来源。论文报告、固定实现观察和解析示例分别标记;未运行研究模型。