DINO 系列:从无标签自蒸馏到稠密特征
交互教程
没有类别标签,模型如何教自己?三代 DINO 又分别改变了什么?
之前已经能做什么
Section titled “之前已经能做什么”本页讲自监督视觉表征 DINO 系列。同名的目标检测模型 DINO 属于另一方法家族;其检测 queries 与目标函数不在本系列范围内。
没有标签,到底在学什么?
Section titled “没有标签,到底在学什么?”DINO 预训练没有人工提供的类别名称。模型看到同一图像的不同裁剪,并学习在这些视图之间保持一致的输出。Backbone f 产生图像级与 patch 特征;独立 head h 把图像级特征映射为 K 个原型分数。这些分数构成预测分布,不是人工类别词表,也不是 VQ 码本。DINO 不用最近码替换 backbone 特征,目标函数也不训练像素解码器。
改变了什么,为什么
Section titled “改变了什么,为什么”阅读顺序从左到右。点击模块,将它与计算和代码对应。代码为教学伪代码;来源链接提供论文方法或已核查的实现。
没有标签,到底在学什么?
DINO 预训练没有人工提供的类别名称。模型看到同一图像的不同裁剪,并学习在这些视图之间保持一致的输出。Backbone f 产生图像级与 patch 特征;独立 head h 把图像级特征映射为 K 个原型分数。这些分数构成预测分布,不是人工类别词表,也不是 VQ 码本。DINO 不用最近码替换 backbone 特征,目标函数也不训练像素解码器。
# Teaching pseudocode; not a complete training implementation.
feature = backbone(view).cls
logits = projection_head(feature)
p = softmax(logits / temperature)训练状态:训练与推理角色在下文分别解释。
两个网络:视图不同,更新方式也不同
原始 DINO 的 teacher 接收两个全局裁剪;student 接收全局裁剪和较小的局部裁剪。二者 backbone 与 head 的结构相同,但参数值不同。每个 teacher 视图与其他 student 视图配对,不与同一视图配对。反向传播只更新 student。Teacher 从 student 初始化,通过指数滑动平均 EMA 跟随它,不是训练开始前另行提供的预训练专家。
# Teaching pseudocode; not a complete training implementation.
teacher = [stop_grad(teacher_net(v)) for v in global_views]
student = [student_net(v) for v in global_views + local_views]
loss = cross_view_ce(teacher, student, exclude_same_view=True)训练状态:训练与推理角色在下文分别解释。
中心化与锐化分别针对不同失败方式
若每张图像都输出同一个常量,视图之间也能一致,却没有有效特征。原始 DINO 先从 teacher logits 减去运行均值向量 c,再使用较低 teacher 温度。中心化限制少数原型维度独占输出;锐化抵抗均匀分布。中心对每个原型维度各有一个值。如果所有 logits 只减同一个标量,它会在 softmax 中抵消,毫无作用。这些操作与 momentum teacher 共同构成经过实验验证的配方;改变一个教学分布不能证明实际训练不会坍塌。
# Teaching pseudocode; not a complete training implementation.
target = stop_grad(softmax((teacher_logits - center) / tau_t))
loss = cross_entropy(target, student_logits / tau_s)
center = mc * center + (1 - mc) * batch_mean(teacher_logits)训练状态:训练与推理角色在下文分别解释。
EMA 是参数更新,不是梯度
令 θt 为旧 teacher,θs 为 optimizer 更新后的 student。m=0.9 时,旧 teacher 参数 0.8 与新 student 参数 0.2 得到 0.74。m=1 时 teacher 不动;m=0 时直接复制 student。计算 student 梯度前,teacher 目标要 detach。Teacher EMA 与中心 EMA 是两个不同状态更新,系数也不同。下游推理通常只保留一个训练好的 backbone,丢弃自蒸馏 head。
# Teaching pseudocode; not a complete training implementation.
student = optimizer_step(student, loss)
# Separate no-gradient state update:
teacher = momentum * teacher + (1 - momentum) * student训练状态:训练与推理角色在下文分别解释。
两个网络:视图不同,更新方式也不同
Section titled “两个网络:视图不同,更新方式也不同”原始 DINO 的 teacher 接收两个全局裁剪;student 接收全局裁剪和较小的局部裁剪。二者 backbone 与 head 的结构相同,但参数值不同。每个 teacher 视图与其他 student 视图配对,不与同一视图配对。反向传播只更新 student。Teacher 从 student 初始化,通过指数滑动平均 EMA 跟随它,不是训练开始前另行提供的预训练专家。
训练架构与参数更新
Section titled “训练架构与参数更新”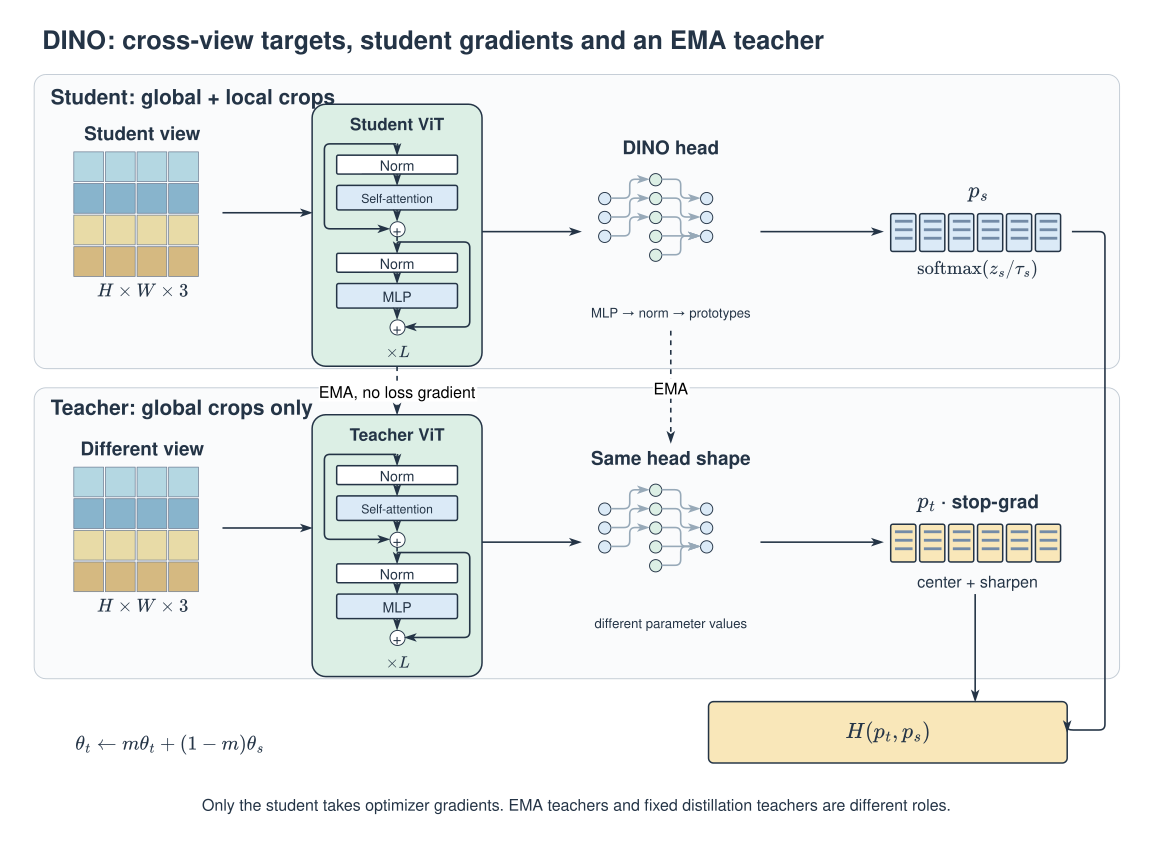
逐步理解机制
Section titled “逐步理解机制”将架构与公式结合阅读。每个版本改变的是学习系统中的具体部分。
中心化与锐化分别针对不同失败方式
Section titled “中心化与锐化分别针对不同失败方式”若每张图像都输出同一个常量,视图之间也能一致,却没有有效特征。原始 DINO 先从 teacher logits 减去运行均值向量 c,再使用较低 teacher 温度。中心化限制少数原型维度独占输出;锐化抵抗均匀分布。中心对每个原型维度各有一个值。如果所有 logits 只减同一个标量,它会在 softmax 中抵消,毫无作用。这些操作与 momentum teacher 共同构成经过实验验证的配方;改变一个教学分布不能证明实际训练不会坍塌。
DINOv2 加入局部目标与规模化训练配方
Section titled “DINOv2 加入局部目标与规模化训练配方”DINOv2 结合图像级 DINO 目标与 iBOT patch 目标。Student 看到被遮盖的 patches,未遮盖的 teacher 在同一裁剪的对应位置提供目标。图像与 patch 损失使用独立 heads。Sinkhorn–Knopp 用来平衡 teacher 分配;KoLeo 鼓励一批归一化图像特征分散。数据筛选、实现效率和最后的高分辨率阶段同样重要,因此不能把 DINOv2 简化成“DINO 换一个更大的 ViT”。
DINOv3 保护稠密特征之间的关系
Section titled “DINOv3 保护稠密特征之间的关系”DINOv3 报告:长时间训练可能改善全局特征,却损害局部一致性。Gram anchoring 选择较早、稠密特征更好的 teacher 作为参照。将 X 的每个 patch 向量归一化后,比较 XXᵀ,即 N×N 的 patch 两两相似度矩阵。它约束关系,却不要求每个通道逐值等于 teacher。若 Q 正交,(XQ)(XQ)ᵀ=XXᵀ,因此通道旋转可以保持该损失。Gram teacher 与通常的 EMA 目标是两个角色,并在 refinement 阶段周期性更新。
公开实现使用 mean squared error,并提供负相似度截断选项。这些设置会改变归一化或所比较的矩阵;数值复现前需要检查选定配置。
系列变化的结构对照
Section titled “系列变化的结构对照”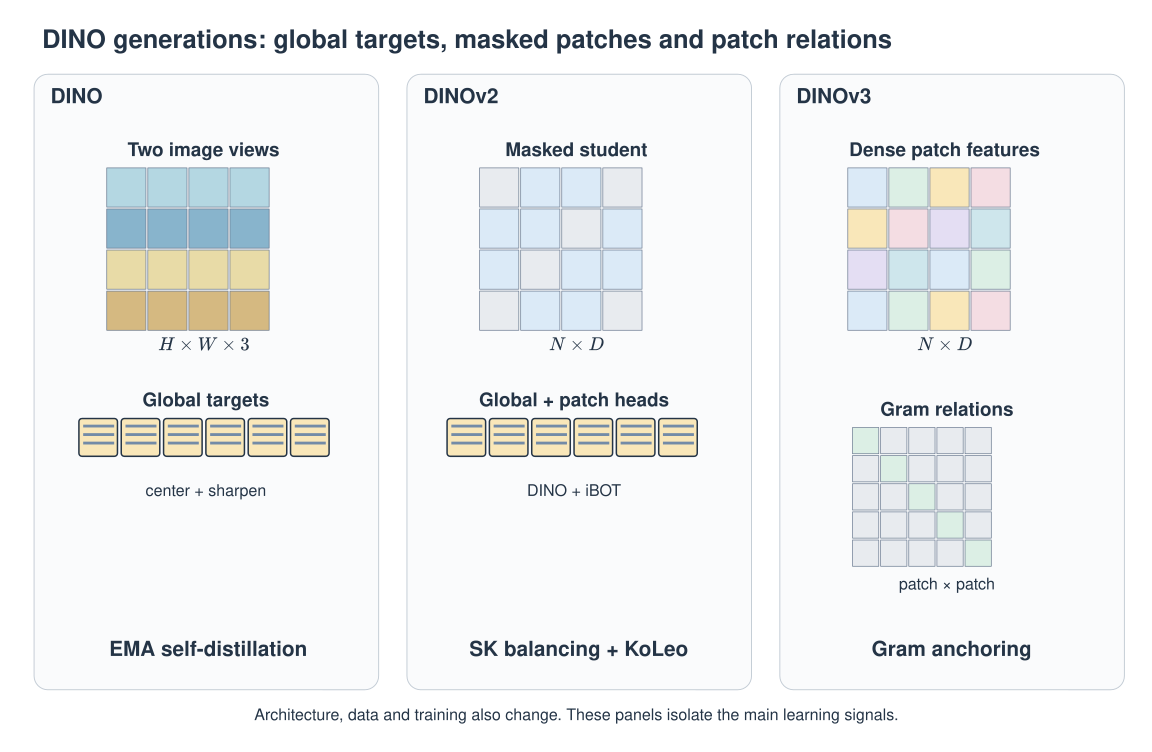
目标函数的局部结构
Section titled “目标函数的局部结构”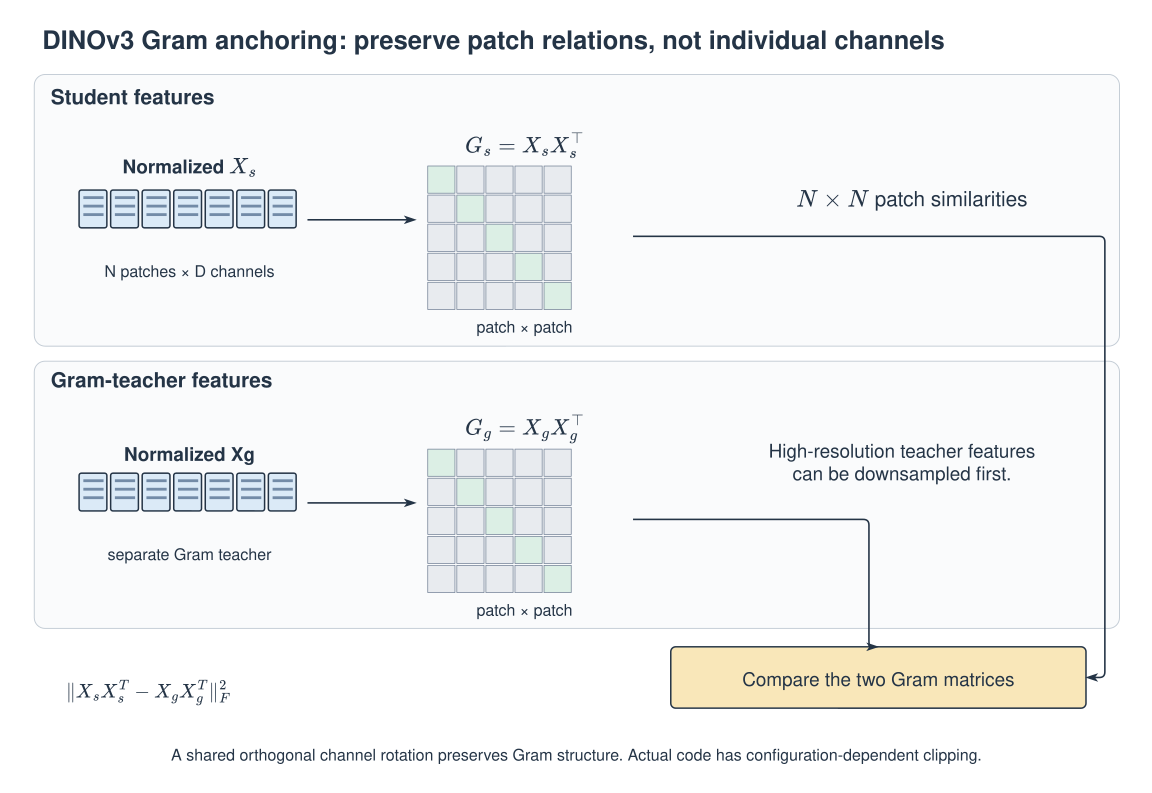
温度、中心化与教师更新
固定的教学向量,只计算概率和损失。数值变化不能证明训练会更稳定或模型效果更好。
教师 logits:[1, 0.3, −0.5];学生 logits:[0.1, 0.8, −0.2],学生温度 0.4。旧教师参数为 0.8,新学生参数为 0.2。
| 原型维度 | 教师概率 | 学生概率 |
|---|---|---|
| 0 | 0.1384 | |
| 1 | 0.7963 | |
| 2 | 0.0654 |
教师熵: · CE: · EMA:
训练与采样的区别
Section titled “训练与采样的区别”EMA 是参数更新,不是梯度
Section titled “EMA 是参数更新,不是梯度”令 θt 为旧 teacher,θs 为 optimizer 更新后的 student。m=0.9 时,旧 teacher 参数 0.8 与新 student 参数 0.2 得到 0.74。m=1 时 teacher 不动;m=0 时直接复制 student。计算 student 梯度前,teacher 目标要 detach。Teacher EMA 与中心 EMA 是两个不同状态更新,系数也不同。下游推理通常只保留一个训练好的 backbone,丢弃自蒸馏 head。
按模块角色理解版本变化
Section titled “按模块角色理解版本变化”DINOv3 也改变模型规模、位置编码和训练方式。大 teacher 使用 RoPE 与 registers;较小的发布模型由固定的大 teacher 蒸馏而来。论文并未在这个小模型蒸馏阶段使用 Gram anchoring。DINOv2 同样区分大模型自蒸馏与小 backbone 蒸馏。Registers 提供内部计算位置,不会把图像 token 压得更短。后续与文本对齐的 DINO 分支增加了图像自监督之外的训练,不能默认为普通 DINO 输出。
这些结果不能证明什么
Section titled “这些结果不能证明什么”从语义 backbone 到重建系统
Section titled “从语义 backbone 到重建系统”CLS 向量概括整张图像;patch 向量保留有索引的空间网格,reshape 前必须排除 registers。RAE 会在语义特征上额外训练图像 decoder。分割或线性探针表现好,不代表像素可以无损重建。比较时必须一起记录 checkpoint、patch 大小、分辨率、特征宽度、归一化、冻结策略与 decoder。本页数值交互只说明目标概率和 EMA 算术,不训练 DINO,也不测量特征质量。
这些特征就是离散重建码吗?
不是。Backbone 输出连续特征。预测原型或文本 ID 不会把它们变成 VQ 码本;重建需要另行定义 decoder 与训练目标。
来源与后续阅读
Section titled “来源与后续阅读”自绘图和伪代码用于教学;原论文图片单独标注来源。论文报告、固定实现观察和解析示例分别标记;未运行研究模型。