CLIP 系列:图文对齐、OpenCLIP 与 SigLIP
交互教程
沿双编码器走到相似度矩阵,再分清损失、数据与训练配方各自的变化。
之前已经能做什么
Section titled “之前已经能做什么”自然语言改变监督接口
Section titled “自然语言改变监督接口”固定分类器为每个训练类别学习一个权重向量。CLIP 则从配对的图像与描述中学习 image encoder 和 text encoder,之后可以把新的类别描述编码为分类器权重。此前已有工作连接语言和图像;CLIP 把简单的对比目标、广泛配对数据和模型扩展结合起来。它的 image encoder 可以是改进 ResNet 或 ViT。本页主图采用 ViT 分支,并不意味着所有 CLIP 都是 ViT。
改变了什么,为什么
Section titled “改变了什么,为什么”阅读顺序从左到右。点击模块,将它与计算和代码对应。代码为教学伪代码;来源链接提供论文方法或已核查的实现。
自然语言改变监督接口
固定分类器为每个训练类别学习一个权重向量。CLIP 则从配对的图像与描述中学习 image encoder 和 text encoder,之后可以把新的类别描述编码为分类器权重。此前已有工作连接语言和图像;CLIP 把简单的对比目标、广泛配对数据和模型扩展结合起来。它的 image encoder 可以是改进 ResNet 或 ViT。本页主图采用 ViT 分支,并不意味着所有 CLIP 都是 ViT。
# Teaching pseudocode; not a complete training implementation.
images, captions = paired_batch()
image_features = image_encoder(images)
text_features = text_encoder(captions)训练状态:训练与推理角色在下文分别解释。
双塔在共享 embedding 空间中相遇
图像塔汇聚图像特征,再投影到 d 维;文本塔将描述分词,经过 causal Transformer,选择结束 token 的表示,也投影到 d 维。将二者归一化为单位向量后,点积就是余弦相似度。输出维度相同,不意味着两塔共享 encoder 权重。原始 CLIP 学习正值 logit scale。在这条双编码器路径中,图像 patches 与词语之间没有 cross-attention。
# Teaching pseudocode; not a complete training implementation.
U = l2_normalize(image_projection(image_features))
V = l2_normalize(text_projection(eos_features))
S = exp(logit_scale) * U @ V.T训练状态:训练与推理角色在下文分别解释。
一个 batch 变成 B×B 个匹配问题
把 B 对图文按相同顺序排列。第 i 行将图像 i 与所有文本比较;第 j 列将文本 j 与所有图像比较。对角线是配对正例。Image-to-text 交叉熵逐行归一化,text-to-image 则逐列归一化,最后平均两个方向。增大一个负例分数会改变同行或同列其他项的 softmax 概率。未配对项被当作负例,即便内容实际上兼容,因此噪声描述与重复内容会影响目标。
# Teaching pseudocode; not a complete training implementation.
labels = arange(batch_size)
row_loss = cross_entropy(S, labels)
column_loss = cross_entropy(S.T, labels)
loss = (row_loss + column_loss) / 2训练状态:训练与推理角色在下文分别解释。
零样本分类复用文本塔
为每个候选类别写一个 prompt,例如 “a photo of a dog”。编码并归一化这些 prompt,它们就构成分类器的列向量。将新图像向量与所有候选比较,选择最大分数。概率取决于候选列表、prompt 措辞和 scale,不是世界中该类别存在的无条件概率。Prompt ensemble 将同一类别的归一化描述做平均,再归一化类别向量。完成这个判断不需要图像 decoder,也不需要自回归文本生成器。
# Teaching pseudocode; not a complete training implementation.
class_vectors = encode_and_normalize(class_prompts)
image_vector = encode_and_normalize(image)
prediction = argmax(image_vector @ class_vectors.T)训练状态:训练与推理角色在下文分别解释。
双塔在共享 embedding 空间中相遇
Section titled “双塔在共享 embedding 空间中相遇”图像塔汇聚图像特征,再投影到 d 维;文本塔将描述分词,经过 causal Transformer,选择结束 token 的表示,也投影到 d 维。将二者归一化为单位向量后,点积就是余弦相似度。输出维度相同,不意味着两塔共享 encoder 权重。原始 CLIP 学习正值 logit scale。在这条双编码器路径中,图像 patches 与词语之间没有 cross-attention。
训练架构与参数更新
Section titled “训练架构与参数更新”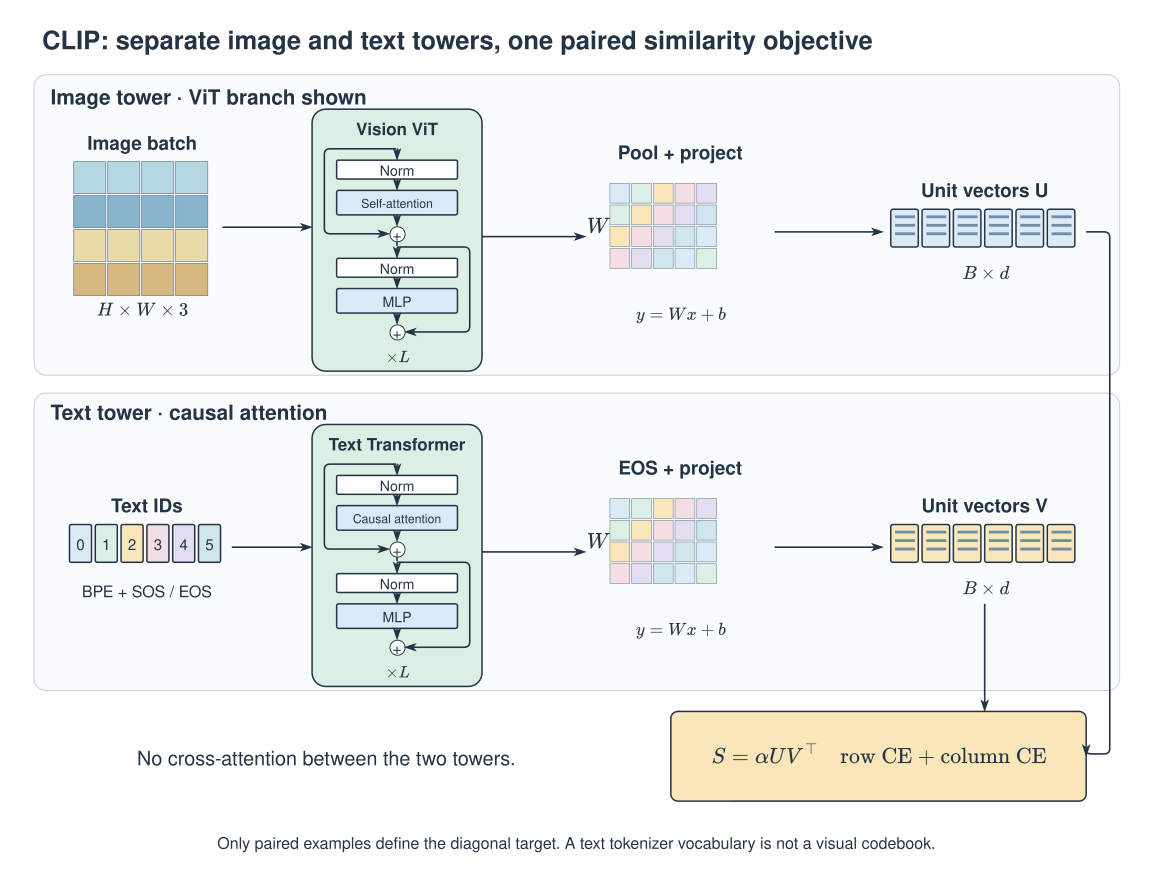
逐步理解机制
Section titled “逐步理解机制”将架构与公式结合阅读。每个版本改变的是学习系统中的具体部分。
一个 batch 变成 B×B 个匹配问题
Section titled “一个 batch 变成 B×B 个匹配问题”把 B 对图文按相同顺序排列。第 i 行将图像 i 与所有文本比较;第 j 列将文本 j 与所有图像比较。对角线是配对正例。Image-to-text 交叉熵逐行归一化,text-to-image 则逐列归一化,最后平均两个方向。增大一个负例分数会改变同行或同列其他项的 softmax 概率。未配对项被当作负例,即便内容实际上兼容,因此噪声描述与重复内容会影响目标。
OpenCLIP 使训练生态更可检查
Section titled “OpenCLIP 使训练生态更可检查”OpenCLIP 是开放实现、训练工具和 checkpoint 集合,并不是一个替换 CLIP 的单一新损失。可复现规模化研究保留对比目标,改变模型大小、LAION 数据规模和训练所见样本数。数据集大小与所见样本数是不同量,因为训练可能重复读取样本。比较时要同时报告架构与训练数据标签:仅写 ViT-L/14,并不能确定唯一的 embedding 分布或权重。
SigLIP 改变目标中的批间归一化
Section titled “SigLIP 改变目标中的批间归一化”SigLIP 把每个图文对当作二分类样本:对角线 yij=+1,其余为 −1。可学习 scale 与 bias 产生 logit,再对每个有标签的 pair 独立应用 log-sigmoid,不使用行或列 softmax 分母。它仍然使用负例,遍历所有 pairs 时数量仍为平方级。原论文用 B 除成对损失总和,而不是 B²。成对形式支持分块计算,不需要全局 softmax 归一化,但不同 pair 仍通过共享模型参数耦合。
系列变化的结构对照
Section titled “系列变化的结构对照”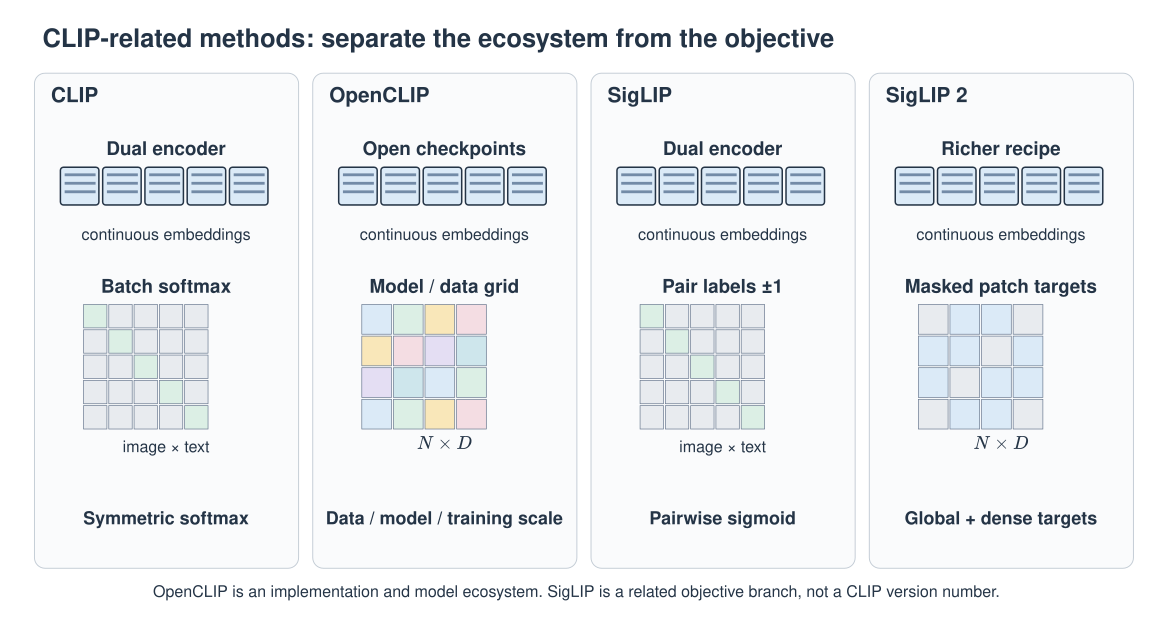
目标函数的局部结构
Section titled “目标函数的局部结构”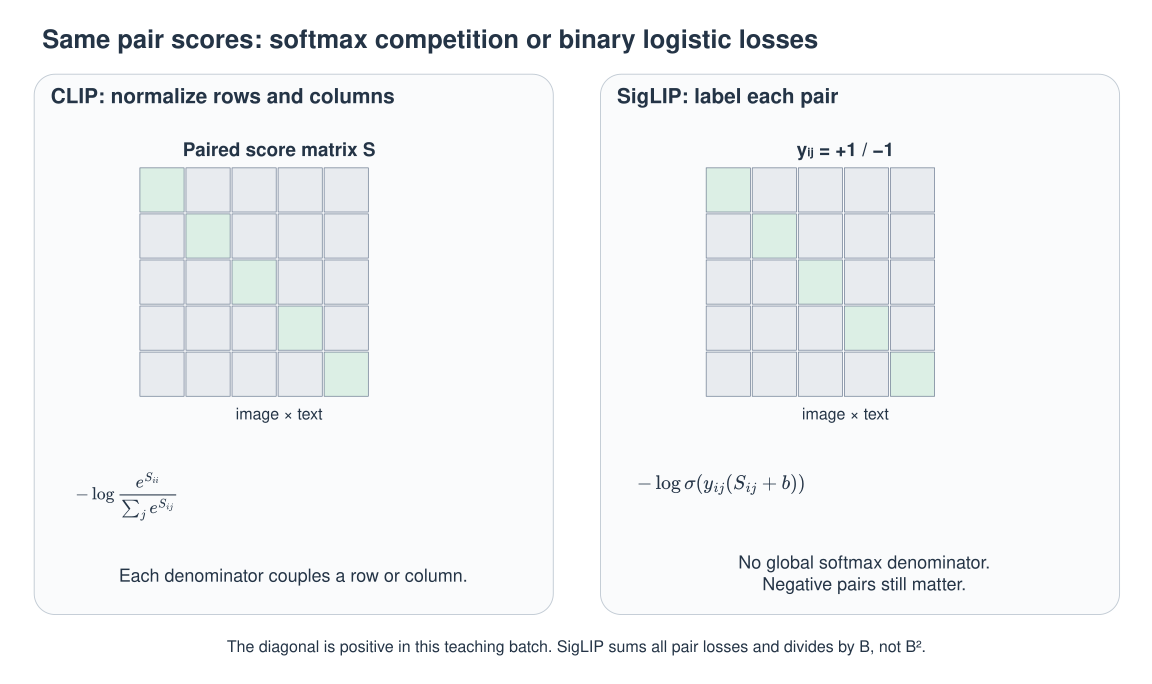
同一相似度矩阵,两种目标
固定的教学向量,只计算概率和损失。数值变化不能证明训练会更稳定或模型效果更好。
三张图的单位向量角度为 0°、75°、150°;三条描述为 10°、65°、160°。切换查看相似度和概率;行是图像,列是文本。
| Image / text | 0 | 1 | 2 |
|---|---|---|---|
| 0 | 0.9432 | 0.0567 | 0.0001 |
| 1 | 0.0561 | 0.9334 | 0.0105 |
| 2 | 0.0002 | 0.0111 | 0.9887 |
I→T: · T→I:
CLIP: · SigLIP:
SigLIP 按原论文以 batch 大小 B 除总成对损失,而非 B²。两种损失尺度不同,不能用较小数值判断谁更好。
训练与采样的区别
Section titled “训练与采样的区别”零样本分类复用文本塔
Section titled “零样本分类复用文本塔”为每个候选类别写一个 prompt,例如 “a photo of a dog”。编码并归一化这些 prompt,它们就构成分类器的列向量。将新图像向量与所有候选比较,选择最大分数。概率取决于候选列表、prompt 措辞和 scale,不是世界中该类别存在的无条件概率。Prompt ensemble 将同一类别的归一化描述做平均,再归一化类别向量。完成这个判断不需要图像 decoder,也不需要自回归文本生成器。
SigLIP 2 同时改进全局与局部特征
Section titled “SigLIP 2 同时改进全局与局部特征”SigLIP 2 结合 sigmoid 图文训练与仅在训练时使用的描述、定位 decoder,之后加入自蒸馏和 masked patch prediction。发布的 vision encoder 不是那个 caption decoder。池化向量支持图文匹配;未池化 patch 特征支持稠密任务与视觉语言接口。固定分辨率版本和 NaFlex 的配方不同。NaFlex 近似保留长宽比,加入 patch 坐标与 padding mask,支持多种序列长度;为控制成本,其适配阶段省略了自蒸馏与 masked-prediction 损失。
这些结果不能证明什么
Section titled “这些结果不能证明什么”VLM 从 CLIP 家族编码器中取走什么
Section titled “VLM 从 CLIP 家族编码器中取走什么”多模态语言模型经常使用全局池化前的 patch 特征,再用 connector 改变宽度或空间位置数。文本词表属于 text tokenizer,不是这些视觉向量的码本。Qwen3-VL 会继续训练由 SigLIP 2 初始化的视觉塔,因此最终表示不等于原始对比学习 checkpoint。用于重建时,RAE decoder 还需学习从选定特征回到像素。图文对齐好,并不保证小文字、几何和纹理都被完整保留。
这些特征就是离散重建码吗?
不是。Backbone 输出连续特征。预测原型或文本 ID 不会把它们变成 VQ 码本;重建需要另行定义 decoder 与训练目标。
来源与后续阅读
Section titled “来源与后续阅读”自绘图和伪代码用于教学;原论文图片单独标注来源。论文报告、固定实现观察和解析示例分别标记;未运行研究模型。