Vision Transformers Need Registers:给 ViT 增加内部计算位置
交互教程
为何有些图像位置变成全局计算空间?先看证据,再追踪新增 token。
之前已经能做什么
Section titled “之前已经能做什么”Patch token 可能不再只表示原来的 patch
Section titled “Patch token 可能不再只表示原来的 patch”ViT 最初为每块图像建立一个向量。经过注意力后,每个向量都可能包含整图信息。因此,输出仍呈网格状,不保证每个位置都保留原来的局部像素。CLS 是单独的可学习读出 token;register 则是额外的可学习输入向量,用来提供内部计算位置。
DINO 通过不同图像视图的教师与学生预测学习表征;CLIP 类方法对齐图像与文字,DeiT 使用类别标签。Registers 是论文在这些训练目标上研究的架构增量,不是一种新的自监督损失或量化码本。
改变了什么,为什么
Section titled “改变了什么,为什么”阅读顺序从左到右。点击模块,将它与计算和代码对应。代码为教学伪代码;来源链接提供论文方法或已核查的实现。
把可学习 registers 放进共享编码器
令 N 为 patch 数、D 为特征宽度、R 为 register 数。输入共有 N+R+1 个位置。Register 初值在不同图像间共享,但经过注意力后的激活随输入图像变化。同一组 Transformer blocks 共同处理 CLS、registers 和 patches。
z = concat(cls, patch_embed(image))
z = z + interpolated_positions
z = concat(z[:, :1], registers, z[:, 1:])
z = transformer(z)训练状态:静态实现审计;训练状态见下文。
丢弃计算位置的输出,保留图像位置
最终归一化后,CLS 位于 0,registers 占据 [1,1+R),图像 patches 占据 [1+R,N+R+1)。只有 patch 特征应还原为空间网格。把 register 向量也放进 reshape,会破坏序列索引与图像位置的对应。
normalized = norm(z)
cls = normalized[:, 0]
reg = normalized[:, 1:1+R]
patch = normalized[:, 1+R:]
image_grid = patch.reshape(B, H_patch, W_patch, D)训练状态:静态实现审计;训练状态见下文。
内部计算位置假设的证据
Section titled “内部计算位置假设的证据”论文发现少量输出 patch 向量具有异常高的范数。在所分析的 DINOv2-g 中,2.37% 超过人为选择的阈值 150。这个阈值是特定模型上的诊断规则,不是通用检测器。异常位置常对应局部信息重复的背景 patch。
线性探针给出两类观察:异常 token 恢复局部位置和像素较差,却比普通 patch 更善于预测整图类别。作者据此解释为:模型复用部分空间位置进行全局计算。这是实验支持的解释,不是“所有高范数向量都有害”的证明。
范数与注意力是不同量。Q/K 投影、归一化和向量方向也影响注意力。特征图更平滑与任务分数更高,应分别检验。
把可学习 registers 放进共享编码器
Section titled “把可学习 registers 放进共享编码器”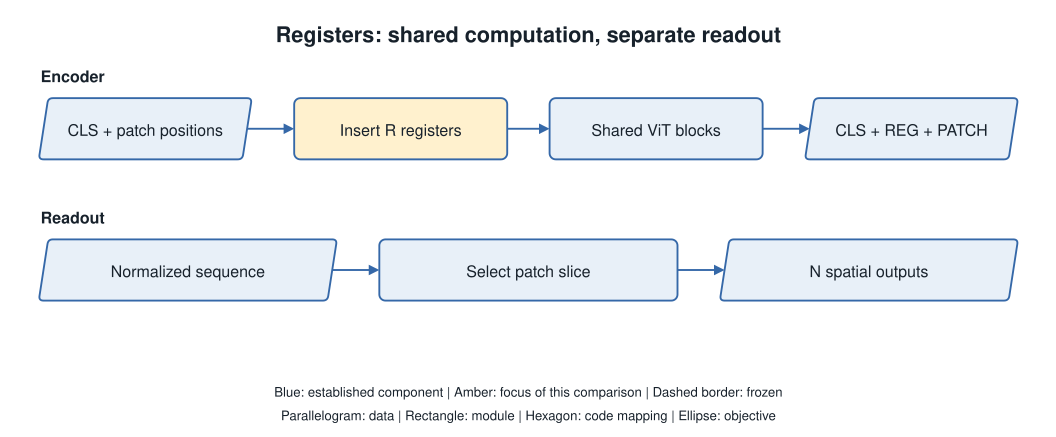
令 N 为 patch 数、D 为特征宽度、R 为 register 数。输入共有 N+R+1 个位置。Register 初值在不同图像间共享,但经过注意力后的激活随输入图像变化。同一组 Transformer blocks 共同处理 CLS、registers 和 patches。
固定 DINOv2 代码先给 CLS 与 patches 加绝对位置,再在 CLS 后插入 registers。论文图中的排列不同;本页切片按代码顺序讲解。先前 memory-token 工作已提供一般机制,本文增量是视觉问题诊断及针对该修复的对照证据。
z = concat(cls, patch_embed(image))
z = z + interpolated_positions
z = concat(z[:, :1], registers, z[:, 1:])
z = transformer(z)- 固定 DINOv2 实现 — prepare_tokens_with_masks
逐步理解机制
Section titled “逐步理解机制”丢弃计算位置的输出,保留图像位置
Section titled “丢弃计算位置的输出,保留图像位置”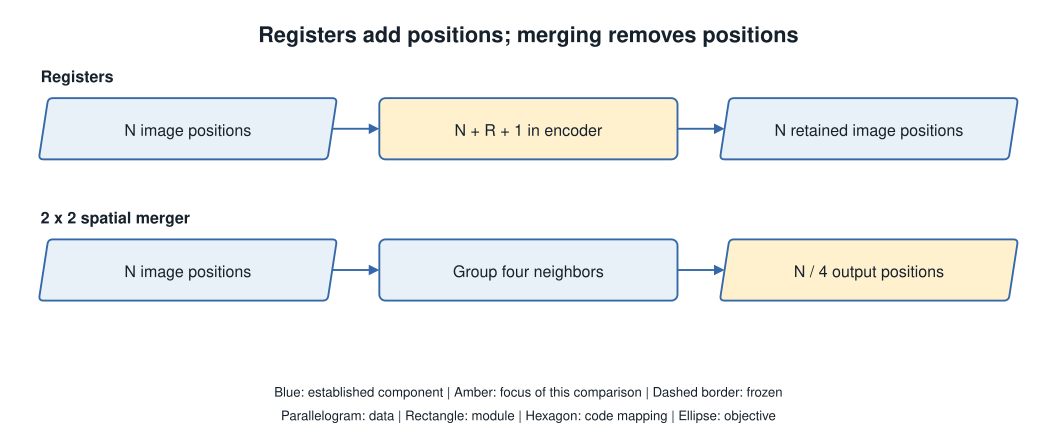
最终归一化后,CLS 位于 0,registers 占据 [1,1+R),图像 patches 占据 [1+R,N+R+1)。只有 patch 特征应还原为空间网格。把 register 向量也放进 reshape,会破坏序列索引与图像位置的对应。
256 个 patches 加四个 registers 时,编码器处理 261 个位置,仍返回 256 个图像位置。四个 768 维输入向量新增 3072 个参数;每头注意力分数矩阵从 257² 增至 261² 项。这个计算不包括投影、MLP 和硬件影响。
normalized = norm(z)
cls = normalized[:, 0]
reg = normalized[:, 1:1+R]
patch = normalized[:, 1+R:]
image_grid = patch.reshape(B, H_patch, W_patch, D)
增加计算位置,保留图像网格
解析示例:固定 16×16=256 个 patch、宽度 768 和一个 CLS。改变 register 数量,只计算序列结构和注意力分数项;不模拟特征质量或训练效果。
| 计算项 | 结果 |
|---|---|
| 主干序列长度 | 261 |
| 保留的图像位置 | 256 |
| Python patch 切片 | [:, 5:261, :] |
| 新增可学习参数 | 3072 |
| 每头注意力分数项 | 68121 |
| 相对 R=0 的项数比 | 1.0314 |
输出切片遵循固定 DINOv2 实现中的 CLS → REG → PATCH 顺序。计算代价比只针对注意力矩阵,不是总 FLOPs 或时延。
训练与采样的区别
Section titled “训练与采样的区别”按新序列训练,核对真实对照条件
Section titled “按新序列训练,核对真实对照条件”实验训练了带 registers 的模型。在现有 checkpoint 上添加未训练向量,不是论文报告的流程。研究在 ImageNet-22k 上使用 DeiT-III ViT-B 和 DINOv2 ViT-L,OpenCLIP ViT-B/16 则使用许可的 Shutterstock 图文语料。这些训练条件不同。
多数实验采用四个 registers,数量消融涵盖 0、1、2、4、8、16。附录还为 DINOv2 位置插值启用 antialiasing。忠实对照应记录该设置、主干规模、训练数据、读出类型和下游协议。数量滑块不能代替这些训练实验。
论文证据(并非本地复现)
Section titled “论文证据(并非本地复现)”| 条件 | 指标 | 数值 | 解释 |
|---|---|---|---|
| DINOv2 → +reg,Table 2 | ADE20k mIoU | 46.6 → 47.9 | 冻结特征线性评估 |
| DINOv2 → +reg,Table 3 | VOC2007 CorLoc | 35.3 → 55.4 | LOST |
| OpenCLIP → +reg,Table 3 | VOC2007 CorLoc | 38.8 → 37.1 | 并非普遍改善的反例 |
这些结果不能证明什么
Section titled “这些结果不能证明什么”它对重建研究意味着什么
Section titled “它对重建研究意味着什么”报告的 LOST 目标发现对照中,DINOv2 改善,而 OpenCLIP 略有下降。因此去除伪影不保证普遍收益。局部线性像素探针不是完整图像解码器,本文也没有证明 registers 能改善 RAE 重建。
对 UAR,先核对冻结编码器返回哪些 token,解码器读取哪些位置,再按需做匹配的编解码对照。Registers 也不是 TiTok 的压缩 latent slots:这里保留原图像网格,并增加内部位置。
丢弃 register 输出,是否意味着它们没有作用?
不是。它们在输出筛选前,已通过共享 blocks 与其他位置交换信息。
来源与后续阅读
Section titled “来源与后续阅读”自绘图和伪代码用于教学;原论文图片单独标注来源。论文报告、固定实现观察和解析示例分别标记;未运行研究模型。