Qwen3.5:审计视觉输入路径
交互教程
原生多模态训练不直接告诉你有哪些视觉模块。沿固定实现追踪。
前置阅读:多模态模型中的视觉 tokenizer 总览 · Qwen3-VL:从图像 patch 到 DeepStack
之前已经能做什么
Section titled “之前已经能做什么”原生多模态训练仍可以使用视觉编码器
Section titled “原生多模态训练仍可以使用视觉编码器”官方模型卡描述训练时对多模态 tokens 进行 early fusion。这说明模态何时一起训练,不意味着 encoder-free 架构。同一模型卡明确把模型归类为带视觉编码器的 causal language model。
这里检查 2B、9B、397B-A17B checkpoints。9B 例子包含 27 层、宽 1152 的视觉 Transformer,以及宽 4096 的语言 embeddings;较小 2B 视觉塔为 24 层、宽 1024,输出宽 2048。架构维度不能确定训练数据或初始化 checkpoint。
改变了什么,为什么
Section titled “改变了什么,为什么”阅读顺序从左到右。点击模块,将它与计算和代码对应。代码为教学伪代码;来源链接提供论文方法或已核查的实现。
沿视觉编码器追踪,而非根据文字主干名称猜测
视觉路径使用 2×16×16 RGB 时空块、可学习 Conv3d 嵌入、插值绝对位置、空间旋转位置和视觉 Transformer blocks。文字主干组合不同注意力机制,不意味着视觉塔也是线性注意力编码器;应分别检查两个模块。
z = patch_embed(pixel_values)
z += interpolate_absolute_positions(grid_thw)
for block in vision_blocks:
z = block(z, rotary_positions)训练状态:静态实现审计;训练状态见下文。
Merger 连接视觉宽度与语言宽度
最终 merger 执行 LayerNorm、空间 2×2 分组与 GELU MLP。已调整 512×512 图像的 1024×1152 编码器特征,先成为 256×4608 的拼接向量,再成为 256×4096 的语言宽度特征。拼接先把四个向量保留为不同坐标,然后才做可学习投影。
merged = vision_output.pooler_output
image_mask = locate_image_placeholders(input_ids)
inputs_embeds = inputs_embeds.masked_scatter(image_mask, merged)训练状态:静态实现审计;训练状态见下文。
与 Qwen3-VL 的已核实差异
已检查的三个 Qwen3.5 配置中,deepstack_visual_indexes 均为空。配置本身还不足以证明运行行为,因此继续追踪实现:Qwen3_5VisionModel 返回最终 merger 输出,多模态 forward 将它写入输入位置;没有返回 Qwen3-VL 的 DeepStack 特征列表,也没有在早期 LLM block 后加入这些特征。
# Inspected Qwen3.5 path
vision = visual(pixel_values, grid_thw)
llm_input[image_positions] = vision.pooler_output
# No intermediate DeepStack additions in this path.训练状态:静态实现审计;训练状态见下文。
沿视觉编码器追踪,而非根据文字主干名称猜测
Section titled “沿视觉编码器追踪,而非根据文字主干名称猜测”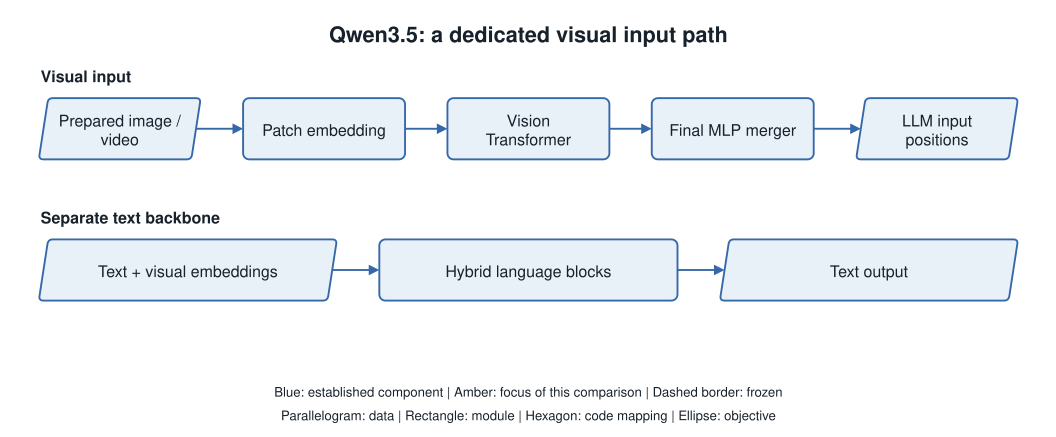
视觉路径使用 2×16×16 RGB 时空块、可学习 Conv3d 嵌入、插值绝对位置、空间旋转位置和视觉 Transformer blocks。文字主干组合不同注意力机制,不意味着视觉塔也是线性注意力编码器;应分别检查两个模块。
单图通过时间复制形成一个时间组。公开 processor 复用 Qwen 图像处理实现,其类名可能包含较早的模型名称;这是实现复用,不是该 checkpoint 属于旧模型的证据。
z = patch_embed(pixel_values)
z += interpolate_absolute_positions(grid_thw)
for block in vision_blocks:
z = block(z, rotary_positions)- 固定视觉模型 — Qwen3_5VisionModel
与 Qwen3-VL 的已核实差异
Section titled “与 Qwen3-VL 的已核实差异”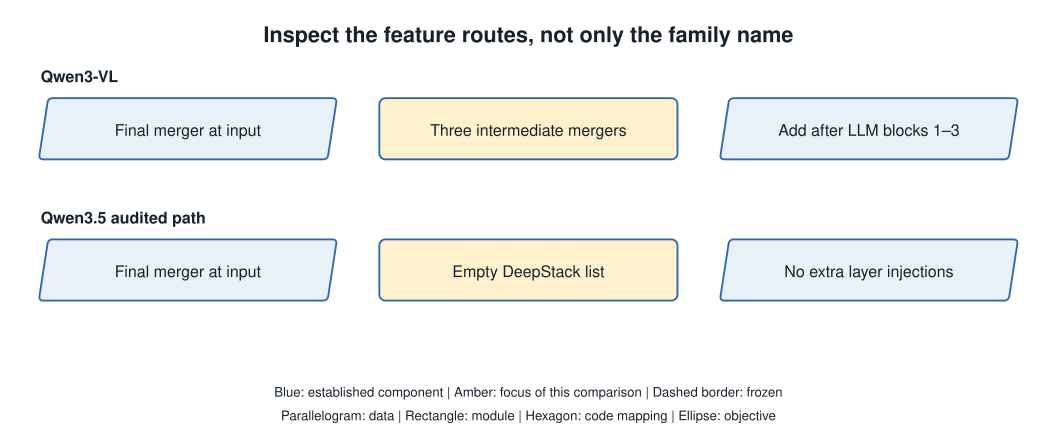
已检查的三个 Qwen3.5 配置中,deepstack_visual_indexes 均为空。配置本身还不足以证明运行行为,因此继续追踪实现:Qwen3_5VisionModel 返回最终 merger 输出,多模态 forward 将它写入输入位置;没有返回 Qwen3-VL 的 DeepStack 特征列表,也没有在早期 LLM block 后加入这些特征。
这是针对固定 checkpoints 和实现的代码观察,不证明去掉 DeepStack 导致任何报告的质量提升。两个家族的语言模型、数据和训练也不同;因果结论需要匹配消融。
# Inspected Qwen3.5 path
vision = visual(pixel_values, grid_thw)
llm_input[image_positions] = vision.pooler_output
# No intermediate DeepStack additions in this path.
逐步理解机制
Section titled “逐步理解机制”Merger 连接视觉宽度与语言宽度
Section titled “Merger 连接视觉宽度与语言宽度”最终 merger 执行 LayerNorm、空间 2×2 分组与 GELU MLP。已调整 512×512 图像的 1024×1152 编码器特征,先成为 256×4608 的拼接向量,再成为 256×4096 的语言宽度特征。拼接先把四个向量保留为不同坐标,然后才做可学习投影。
视觉向量通过 mask 替换 image 占位 embeddings。因此重复的占位 ID 标记位置,具体图像内容由写入的向量携带。已检查路径中没有最近邻码本查找。
merged = vision_output.pooler_output
image_mask = locate_image_placeholders(input_ids)
inputs_embeds = inputs_embeds.masked_scatter(image_mask, merged)
从像素尺寸追踪到视觉 token
形状计算,不运行模型。图像模式复现固定版本的尺寸取整规则;Qwen 的预算在此指定为最大视觉 token 对应的像素面积,不是服务商计费值。
| 阶段/计算项 | 结果 |
|---|---|
| 调整后高度 | 512 |
| 调整后宽度 | 512 |
| 时间组数 | 1 |
| 补齐/复制帧数 | 1 |
| 模型 patch 网格行数 | 32 |
| 模型 patch 网格列数 | 32 |
| 预处理空间单位 × 时间组 | 1024 |
| 模型 patch 位置数 | 1024 |
| 有效视觉 token | 256 |
| LLM 视觉特征形状 | [256, 4096] |
| 连续标量数 | 1048576 |
2×16×16 patches → ViT → 2×2 concat + MLP → LLM
27 vision blocks · width 1152 → 4096
输入:视觉 embedding 写入图像位置,文字 embedding 保留。
有效 token 不包括 padding 槽、图片边界、换行、时间戳文字或其他文本。视频模式不执行抽帧和视频预算分配:输入边长必须是 Qwen 的 32 或 Gemma 的 48 的倍数。单图的帧复制是时空 patch 接口操作,不意味着有运动信息。
已核对的具体配置
核对日期:2026-11-03. 每行链接到固定版本。参数相同不表示权重相同;12B 的 patch 列表示模型接收的像素块。
| 型号 | 模型 patch | 视觉层/宽 | 空间操作 | LLM 宽 | DeepStack 零基层 |
|---|---|---|---|---|---|
| Qwen3.5-2B | 16×16 | 24 / 1024 | 2×2 concat + MLP | 2048 | — |
| Qwen3.5-9B | 16×16 | 27 / 1152 | 2×2 concat + MLP | 4096 | — |
| Qwen3.5-397B-A17B | 16×16 | 27 / 1152 | 2×2 concat + MLP | 4096 | — |
“—”表示本轮检查的路径没有 DeepStack 注入,不表示没有视觉信息。所有分支传递连续向量;本表没有把文字词表大小当作视觉码本。
把训练陈述与源码观察分开
Section titled “把训练陈述与源码观察分开”模型卡报告统一视觉语言基础及广泛多模态结果;本轮审计资料没有给出完整的视觉单独预训练配方,或视觉塔明确的初始化 checkpoint。综述将这些字段保留为未披露,不凭与 Qwen3-VL 相似来补齐。
Qwen3.5 仓库入口目前重定向至更新家族,因此本文引用固定 Qwen3.5 模型 revision 与源码 commit,不悄悄使用新版 README 或 Omni 模型报告来证明这些 checkpoints 的结构。
这些结果不能证明什么
Section titled “这些结果不能证明什么”重建实验还需要什么
Section titled “重建实验还需要什么”Early fusion 不会自动产生像素解码器。重建研究必须选择 merger 前或后的特征,定义 decoder 如何处理其空间布局,再用图像目标训练。文字生成成功不是重建指标。
计算器用于检查序列和宽度变化,包括视频末帧复制;它只计算形状,不能给 Qwen3.5 与 Qwen3-VL 排名、估计缺失的训练成本,或预测 merger 保留了多少像素细节。
层数相同,能否推断视觉初始化来源相同?
不能。架构和权重来源是不同证据。
来源与后续阅读
Section titled “来源与后续阅读”自绘图和伪代码用于教学;原论文图片单独标注来源。论文报告、固定实现观察和解析示例分别标记;未运行研究模型。