Gemma 4:视觉编码器、池化与 encoder-free 分支
交互教程
比较五种型号,同时保留 12B 在架构上的关键差异。
之前已经能做什么
Section titled “之前已经能做什么”一个家族,三种视觉配置
Section titled “一个家族,三种视觉配置”E2B 与 E4B 使用约 150M 的视觉编码器,16 层、宽 768;31B 与 26B-A4B 使用约 550M 编码器,27 层、宽 1152;12B 则去掉独立视觉 Transformer。把五种型号概括成一个视觉 tokenizer,会隐藏主要架构差异。
文字词表约有 262K 项,这是文字 tokenizer 的属性,不是视觉码字数量。同样,为紧凑权重进行量化感知训练,不意味着图像表示采用离散 VQ 码本。
改变了什么,为什么
Section titled “改变了什么,为什么”阅读顺序从左到右。点击模块,将它与计算和代码对应。代码为教学伪代码;来源链接提供论文方法或已核查的实现。
先编码小 patch,再做空间平均
编码器分支采用 16×16 RGB patches。可学习投影与二维绝对位置送入带 axial 2D rotary 的双向视觉 Transformer blocks。完成图像范围内的处理后,对 3×3 空间特征分组平均,再归一化/缩放并投影到语言宽度。
z = vision_transformer(patches16, positions_xy)
z = spatial_average_pool(z, kernel=3)
valid_z = remove_padding(z, valid_mask)
visual = language_projection(valid_z)训练状态:静态实现审计;训练状态见下文。
Token 预算是上限,不是精确输出数
支持的图像预算为 70、140、280、560、1120 个 soft tokens。设池化后空间单位 m=16×3=48 像素,理想目标面积为预算×48²。两边同时乘以“目标面积除以原面积”的平方根,再分别向下取 48 的倍数。
H2, W2 = aspect_ratio_resize(H, W, max_soft_tokens=B)
patch_count = (H2 // 16) * (W2 // 16)
valid_soft_tokens = patch_count // 9训练状态:静态实现审计;训练状态见下文。
12B 直接投影大像素块,不经过独立视觉塔
12B 模型每个像素块接收 48×48×3=6912 个值,并使用轻量嵌入路径。配置仍写有 processor patch_size=16、pooling_kernel_size=3,但 model_patch_size=48。Processor 把 3×3 小像素块重新排列为大块;重排像素不等于平均编码后的特征。
raw48 = repack_pixel_patches(raw16, group_side=3)
z = ln2(dense(ln1(raw48)))
z = ln3(z + position_x + position_y)
visual = multimodal_projection(rms_norm(z))训练状态:静态实现审计;训练状态见下文。
先编码小 patch,再做空间平均
Section titled “先编码小 patch,再做空间平均”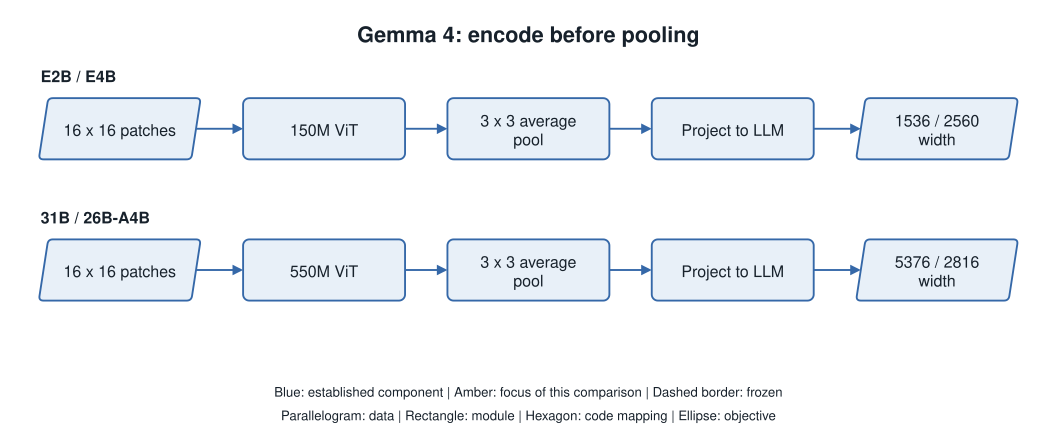
编码器分支采用 16×16 RGB patches。可学习投影与二维绝对位置送入带 axial 2D rotary 的双向视觉 Transformer blocks。完成图像范围内的处理后,对 3×3 空间特征分组平均,再归一化/缩放并投影到语言宽度。
池化发生在视觉塔已交换信息之后,把九个特征位置减为一个;这不等同于在编码器前平均原始像素。LLM 宽度依型号不同:E2B 为 1536,E4B 为 2560,31B 为 5376,26B-A4B 为 2816。
z = vision_transformer(patches16, positions_xy)
z = spatial_average_pool(z, kernel=3)
valid_z = remove_padding(z, valid_mask)
visual = language_projection(valid_z)12B 直接投影大像素块,不经过独立视觉塔
Section titled “12B 直接投影大像素块,不经过独立视觉塔”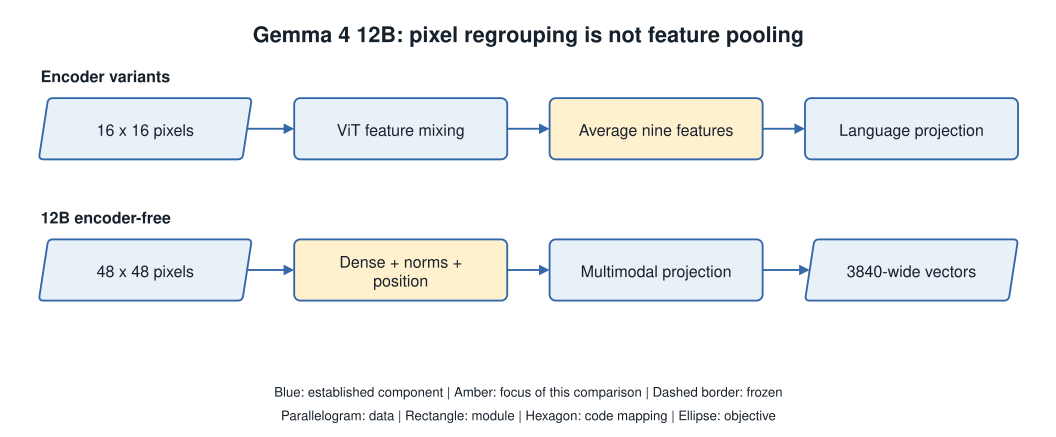
12B 模型每个像素块接收 48×48×3=6912 个值,并使用轻量嵌入路径。配置仍写有 processor patch_size=16、pooling_kernel_size=3,但 model_patch_size=48。Processor 把 3×3 小像素块重新排列为大块;重排像素不等于平均编码后的特征。
所检查实现依次执行 LayerNorm、dense 投影、LayerNorm、分解式 x/y 位置嵌入、另一层 LayerNorm,再经过 RMSNorm 和多模态投影,输出宽 3840。报告中的“single large matmul”概括主要视觉投影,完整接口还包含这些操作。
raw48 = repack_pixel_patches(raw16, group_side=3)
z = ln2(dense(ln1(raw48)))
z = ln3(z + position_x + position_y)
visual = multimodal_projection(rms_norm(z))- 固定 encoder-free 实现 — Gemma4UnifiedVisionEmbedder
逐步理解机制
Section titled “逐步理解机制”Token 预算是上限,不是精确输出数
Section titled “Token 预算是上限,不是精确输出数”支持的图像预算为 70、140、280、560、1120 个 soft tokens。设池化后空间单位 m=16×3=48 像素,理想目标面积为预算×48²。两边同时乘以“目标面积除以原面积”的平方根,再分别向下取 48 的倍数。
整数网格会略微改变长宽比,也可能用不满预算。报告 Figure 2 中,572×1024(宽×高)图像以说明用预算 10 调整为 96×192,得到 72 个小 patches 和八个 soft tokens。10 用来说明算法,不是公开 processor 接受的预算。代码还处理极窄图向下取整后某边为零的情形。
H2, W2 = aspect_ratio_resize(H, W, max_soft_tokens=B)
patch_count = (H2 // 16) * (W2 // 16)
valid_soft_tokens = patch_count // 9原图:预算不必被填满
Section titled “原图:预算不必被填满”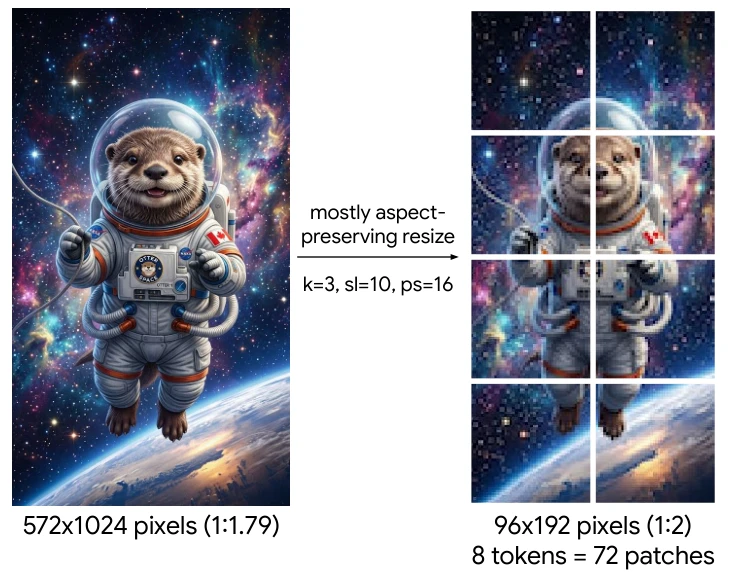
图中用预算 10 说明取整,交互模型预设只使用公开支持的图像预算。
从像素尺寸追踪到视觉 token
形状计算,不运行模型。图像模式复现固定版本的尺寸取整规则;Qwen 的预算在此指定为最大视觉 token 对应的像素面积,不是服务商计费值。
| 阶段/计算项 | 结果 |
|---|---|
| 调整后高度 | 768 |
| 调整后宽度 | 768 |
| 时间组数 | 1 |
| 补齐/复制帧数 | 0 |
| 模型 patch 网格行数 | 48 |
| 模型 patch 网格列数 | 48 |
| 预处理空间单位 × 时间组 | 2304 |
| 模型 patch 位置数 | 2304 |
| 有效视觉 token | 256 |
| LLM 视觉特征形状 | [256, 5376] |
| 连续标量数 | 1376256 |
16×16 patches → ViT → 3×3 average pool → LLM
27 vision blocks · width 1152 → 5376
输入:视觉 embedding 写入图像位置,文字 embedding 保留。
有效 token 不包括 padding 槽、图片边界、换行、时间戳文字或其他文本。视频模式不执行抽帧和视频预算分配:输入边长必须是 Qwen 的 32 或 Gemma 的 48 的倍数。单图的帧复制是时空 patch 接口操作,不意味着有运动信息。
已核对的具体配置
核对日期:2026-11-03. 每行链接到固定版本。参数相同不表示权重相同;12B 的 patch 列表示模型接收的像素块。
| 型号 | 模型 patch | 视觉层/宽 | 空间操作 | LLM 宽 | DeepStack 零基层 |
|---|---|---|---|---|---|
| gemma-4-E2B-it | 16×16 | 16 / 768 | 3×3 average | 1536 | — |
| gemma-4-E4B-it | 16×16 | 16 / 768 | 3×3 average | 2560 | — |
| gemma-4-12B-it | 48×48 | 0 / 3840 | Pixel projection | 3840 | — |
| gemma-4-31B-it | 16×16 | 27 / 1152 | 3×3 average | 5376 | — |
| gemma-4-26B-A4B-it | 16×16 | 27 / 1152 | 3×3 average | 2816 | — |
“—”表示本轮检查的路径没有 DeepStack 注入,不表示没有视觉信息。所有分支传递连续向量;本表没有把文字词表大小当作视觉码本。
按各自训练条件比较路径
Section titled “按各自训练条件比较路径”报告说明独立视觉编码器在预训练中冻结,而 encoder-free 12B 从头训练。公开推理类本身不保证历史 optimizer 调度,复现需要明确参数组及对应训练配方。
两条路线都出现 48 像素输出单位:一条先让小 patches 在预训练视觉塔中交互再池化,另一条让语言主干处理直接投影的大像素块。相同输出数不等于相同视觉计算或细节保留。
这些结果不能证明什么
Section titled “这些结果不能证明什么”哪些信息仍未知或不在本次比较内
Section titled “哪些信息仍未知或不在本次比较内”已检查报告不足以为所有编码器分支指定某个精确 SigLIP 初始化 checkpoint,因此保留未知。比较涉及视觉输入与文字输出,不是图像解码器;音频与多 token 预测不在本页审计范围内。
用于重建研究时,应区分池化前 patch 特征、池化后特征和 encoder-free 投影块。它们的训练历史与空间接口不同,基于其中任意一种训练像素 decoder 都是独立实验。
Processor 的 patch_size=16 能证明 Gemma 4 12B 有 patch-16 视觉 Transformer 吗?
不能。Processor 将像素重排为 48×48 块,模型使用无独立视觉塔的投影路径。
来源与后续阅读
Section titled “来源与后续阅读”自绘图和伪代码用于教学;原论文图片单独标注来源。论文报告、固定实现观察和解析示例分别标记;未运行研究模型。